История и устройство ОС: атлас схем
Загрузка, POSIX, процессы и systemd. Исторические и технические схемы с подробным разбором и командами наблюдения.
Пара 1: История ОС: от очереди заданий до GNU/Linux
Подробный разбор: История ОС: от очереди заданий до GNU/Linux
Первые ОС управляли очередью работы
ОС появилась как способ использовать дорогое оборудование, а не как графический рабочий стол.
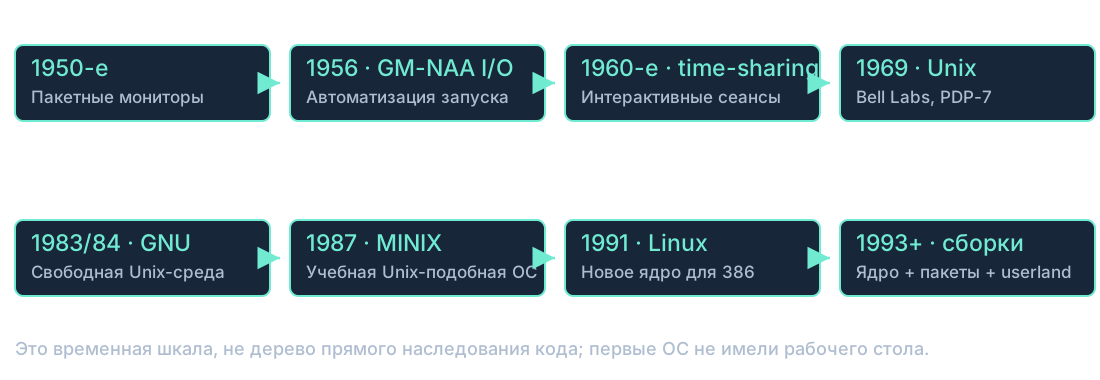
На ранних компьютерах запуск программы и подготовка устройств требовали большого участия оператора. Пакетный монитор автоматизировал переход от одного задания к следующему, стандартный ввод/вывод и обработку сбоев. GM-NAA I/O для IBM 704, созданная в 1956 году, — один из классических ранних примеров: утверждение «самая первая ОС» зависит от того, какие мониторы и инструменты включать в определение. Time-sharing в 1960-х дал многим пользователям интерактивные сеансы, пока CPU быстро переключался между задачами. Это потребовало защиты памяти, планирования и учёта ресурсов. Multics исследовал богатую многопользовательскую систему; Unix возник позже в другой команде и с более компактным подходом. Интерфейс рабочего стола — сравнительно поздний слой. Серверная ОС прекрасно выполняет работу без графического окружения.
Практическое следствие: Пакетная обработка оптимизировала очереди; time-sharing дал интерактивность. Современная ОС объединяет множество таких механизмов.
Unix: реализация, семейство и влияние
Linux похож на Unix по интерфейсам, но не является переименованным MINIX.
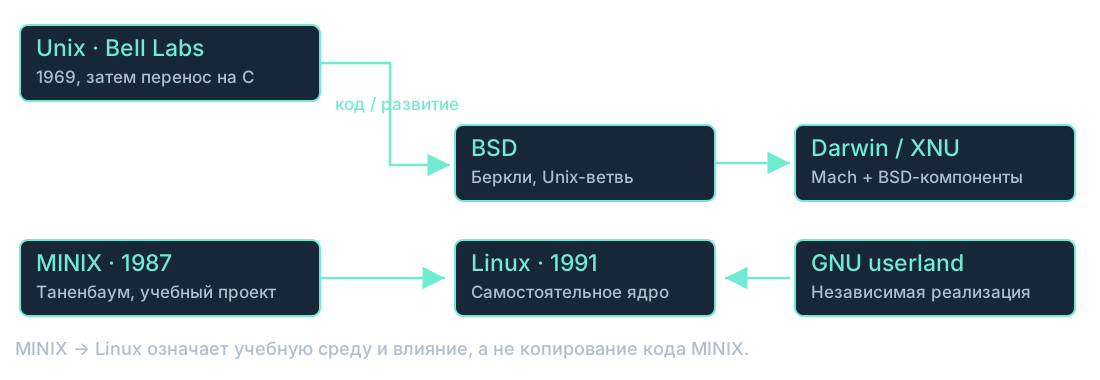
В 1969 году в Bell Labs Кен Томпсон, Деннис Ритчи и коллеги начали Unix на PDP-7 после участия лаборатории в Multics. Система постепенно получила файловую модель, процессы, shell и инструменты; перенос значительной части на C в 1970-х облегчил развитие на другом оборудовании. BSD выросла из Unix-окружения в Беркли; её наследие участвует в Darwin/macOS наряду с Mach. MINIX, опубликованный Таненбаумом в 1987 году для изучения ОС, предоставлял небольшой Unix-подобный пример. Торвальдс работал с MINIX и в 1991 году создал собственное ядро для 386. Его код нельзя описывать как скопированный MINIX: влияние, совместимость и прямое происхождение исходников — разные отношения. Дискуссия Таненбаума и Торвальдса затрагивала монолитное ядро и микроядерный подход; это не история рождения Git.
Практическое следствие: Сплошные ветви BSD обозначают развитие кодовой семьи; связь MINIX и Linux поясняет учебную среду и влияние, без утверждения о копировании.
GNU появился раньше ядра Linux
Рабочая система состоит из ядра и множества пользовательских компонентов.
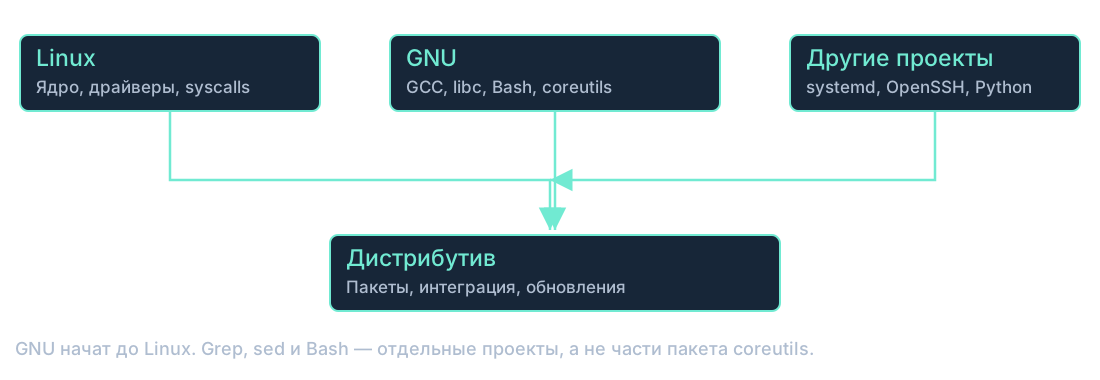
Ричард Столлман объявил GNU в 1983 году; работа началась в 1984-м. Целью была свободная Unix-совместимая система. До появления Linux уже развивались компилятор GCC, shell, библиотеки и утилиты. Linux дал самостоятельное ядро, вокруг которого можно было собрать рабочую среду с GNU и другими проектами. Поэтому ls не «написан внутри Linux-ядра», а Bash не является его частью. В Ubuntu типичны GNU libc и GNU coreutils. Coreutils объединяет прежние fileutils, shellutils и textutils: среди команд ls, cp, mv, chmod, cat, sort, uniq, wc. Grep и sed — отдельные GNU-проекты, awk имеет несколько реализаций; всё это нельзя называть одним пакетом «gnuutils». Alpine часто использует musl и BusyBox, поэтому не любая система с Linux содержит полный GNU-userland.
Практическое следствие: Linux — ядро. Дистрибутив собирает совместимые версии ядра, библиотек, утилит, служб и приложений.
Дистрибутив выбирает интеграцию и обновления
Происхождение пакетов объясняет совместимость, но не делает потомков одинаковыми.
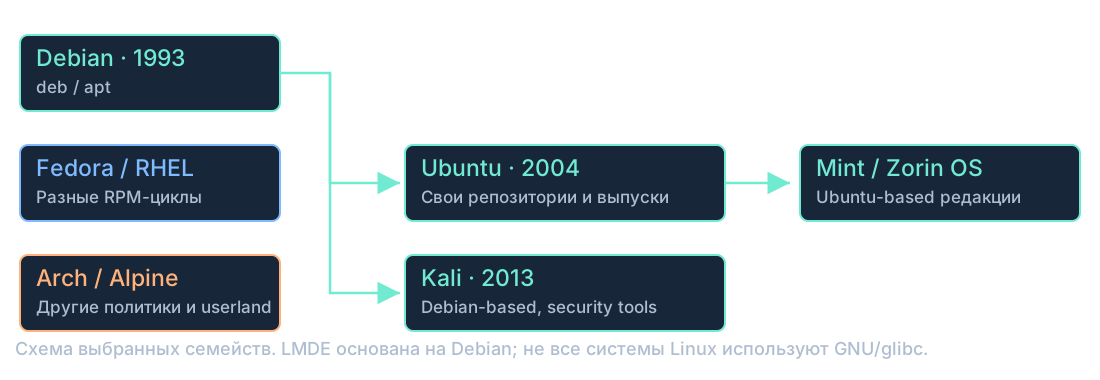
Debian появился в 1993 году; Ubuntu развивается с 2004-го как производная Debian со своими выпусками, репозиториями и интеграцией. Ubuntu-based редакции Mint и Zorin OS наследуют часть этой базы, но LMDE является отдельной Debian-based линией. Kali с 2013 года основан на Debian; прежний BackTrack имел другую историю: Slackware в ранних версиях, затем Ubuntu. Fedora и RHEL относятся к RPM-экосистеме, но имеют разные циклы развития и поддержки. Arch делает другой выбор в пользу rolling release, Alpine — компактности и другого userland. Даже общая основа не разрешает смешать репозитории Debian, Ubuntu и Kali: версии ABI, dependencies и настройки могут расходиться. На занятиях используем один выпуск Ubuntu, чтобы отделять Linux-механизмы от особенностей пакетов.
Практическое следствие: Дистрибутив задаёт пакеты, libc, init и политику обновлений.
Опыт: связать рисунок с наблюдением
uname -srm
cat /etc/os-release
command -v bash ls grep sed
ls --version | head -n 1
ps -p 1 -o pid,comm,args
В паспорте среды отдельно запишите ядро, дистрибутив, shell и PID 1. На Mac вместо /etc/os-release используйте sw_vers, а для BSD ls не запускайте --version. WSL2 устанавливается по инструкции первой пары; установка выполняется до занятия.
Источники подробного разбора
Пара 2: От кнопки питания до программы: загрузка, ядро и POSIX; Firmware, драйверы и ремонтная Live-среда
Подробный разбор: От кнопки питания до программы: загрузка, ядро и POSIX; Firmware, драйверы и ремонтная Live-среда
BIOS и UEFI начинают загрузку по-разному
Legacy BIOS читает bootstrap-код, UEFI запускает EFI-программу.
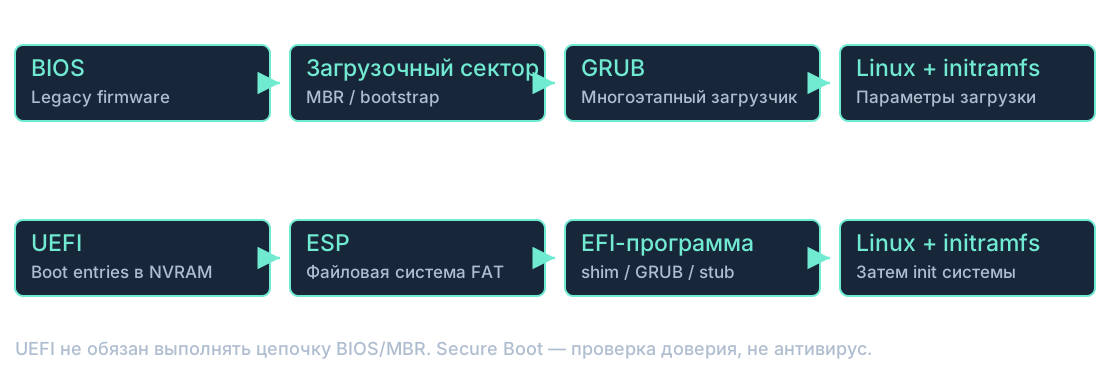
В legacy BIOS после начальной аппаратной подготовки выбирается загрузочное устройство и исполняется начальный загрузочный код, обычно связанный с MBR. Крошечный первый этап не содержит полноценную ОС и передаёт управление следующим этапам загрузчика. UEFI имеет иной интерфейс: записи загрузки ведут к EFI-программам на ESP. GPT часто сочетается с UEFI, но таблица разделов и firmware — разные понятия. GRUB может работать в разных вариантах; расположение и цепочка его файлов зависят от установки. После выбора записи он загружает ядро и initramfs, передаёт command line, например сведения о root. Secure Boot добавляет проверку доверия; shim помогает встроить доверенные компоненты в выбранную цепочку. В WSL2 эту физическую цепочку проходит Windows-хост, а не каждый запуск Ubuntu.
Практическое следствие: Наличие UEFI не означает обязательный GRUB. Внешний USB тоже может содержать EFI-загрузчик и полноценную Live-среду.
Драйверы связывают ядро с устройствами
Драйвер, модуль ядра и firmware устройства — связанные, но разные вещи.
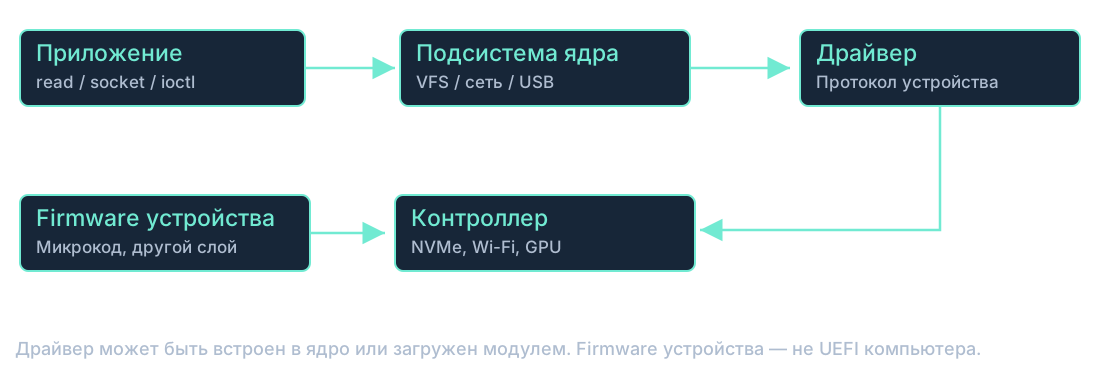
Ядро распознаёт устройства через соответствующие шины и подсистемы. Драйвер знает, как работать с конкретным контроллером или классом устройств; более высокий слой предоставляет приложению общий интерфейс. Драйвер может быть встроен в ядро или находиться в загружаемом модуле .ko. Modprobe учитывает зависимости модулей; lsmod показывает загруженные модули, но отсутствие строки не доказывает отсутствие встроенного драйвера. Некоторым устройствам нужна отдельная firmware, загружаемая драйвером: это не тот же код, что UEFI компьютера. /sys представляет объекты ядра и их связи, /dev — интерфейсы устройств; udev участвует в обработке событий и именовании пользовательской среды. Если драйвер хранения нужен для root и не встроен, он должен быть доступен достаточно рано, обычно в initramfs. Для наблюдения читаем lspci -k, lsmod и журнал, не выгружаем модуль диска на работающей системе.
Практическое следствие: Ubuntu: lspci -k, lsmod, modinfo имя_модуля, journalctl -k -b. В VM и WSL состав устройств отличается от физического PC.
Как Ubuntu доходит до PID 1
Каждый этап передаёт управление следующему; терминал появляется в конце.
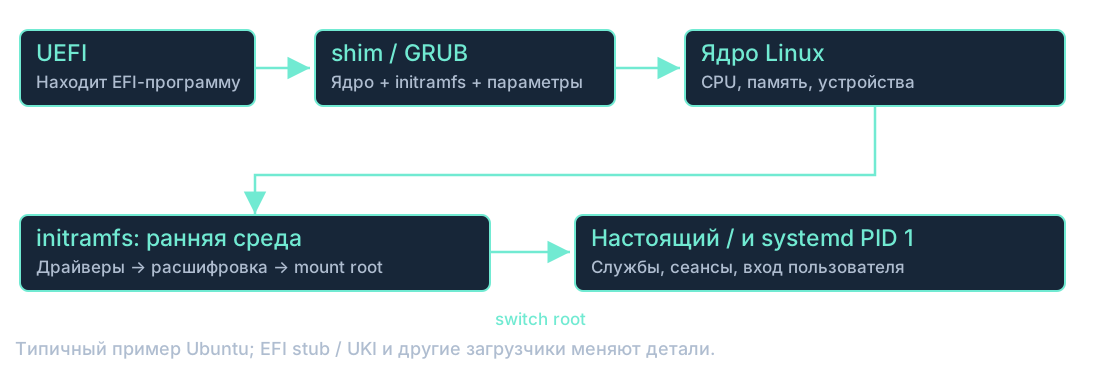
Рассматриваем типичную Ubuntu на компьютере с UEFI, а не учебную WSL2. Сразу после включения выполняется firmware: это код, который ещё не является Linux. UEFI выбирает загрузочную запись и запускает EFI-программу с EFI System Partition. В Ubuntu с Secure Boot часто участвует shim, затем GRUB. Загрузчик выбирает ядро, передаёт ему параметры и initramfs. Ядро начинает управлять процессором, памятью и устройствами. Ранняя пользовательская среда получает доступ к настоящему корневому разделу, после чего управление переходит init установленной системы. В нашей Ubuntu это systemd с PID 1. Менеджер запускает нужные службы; позже появляется сеанс пользователя, а в нём терминал и shell. Secure Boot проверяет доверие к исполняемым компонентам, но не заменяет проверку исправности сервиса. Возможны другие загрузчики, EFI stub и единый образ UKI: схема показывает роли, а не единственный обязательный набор файлов.
Аналогия: сначала открыть здание и включить коммуникации, затем организовать работу отделов. Linux не ждёт входа человека, чтобы запустить серверные службы.
Практическое следствие: Нет. Bash — программа пользовательской среды, запускаемая после ранних этапов загрузки.
Зачем нужен initramfs
Чтобы открыть настоящий корень, иногда сначала нужна маленькая среда в памяти.
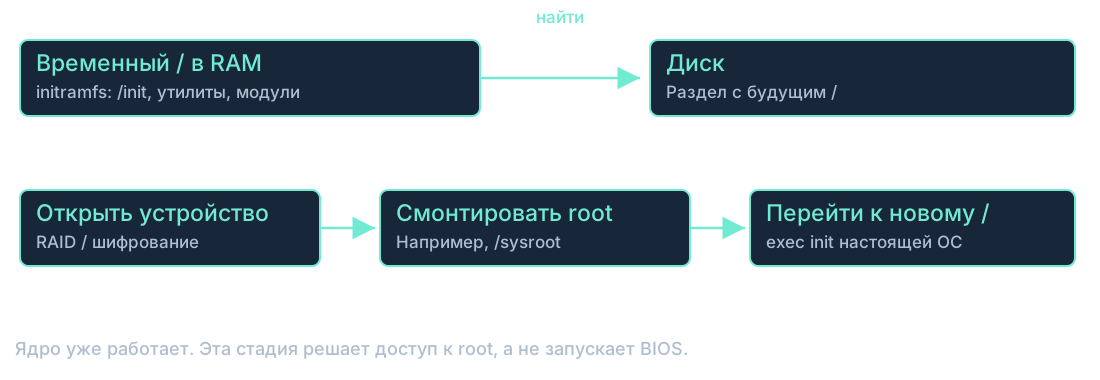
Представьте зашифрованный диск: чтобы открыть его, нужны драйверы, утилита и ключ; но утилиты установленной ОС лежат на этом же диске. Initramfs разрывает этот круг. Это ранняя файловая система, содержимое которой загружено в память: в ней есть необходимый init, модули и инструменты. Она помогает найти устройство, собрать нужные слои хранения, при необходимости получить ключ и смонтировать будущий корень. Затем выполняется переход к настоящему root и запуск его init. Это не второй Linux и не аналог swap. Уже работает то же ядро. На некоторых системах ранний init тоже является systemd; упрощённая схема не обещает, что systemd всегда впервые появляется только после switch root. Не предлагайте группе менять загрузочные разделы: задача — понять причину сообщений, а не сломать учебный ноутбук.
Аналогия: аварийный набор с ключом позволяет открыть склад, где лежат основные инструменты. RAM не является постоянным архивом.
Практическое следствие: В ранней среде и цепочке доступа к root; пользовательский Bash ещё не нужен.
Отказы на разных стадиях загрузки
Последний успешный этап сужает круг причин.
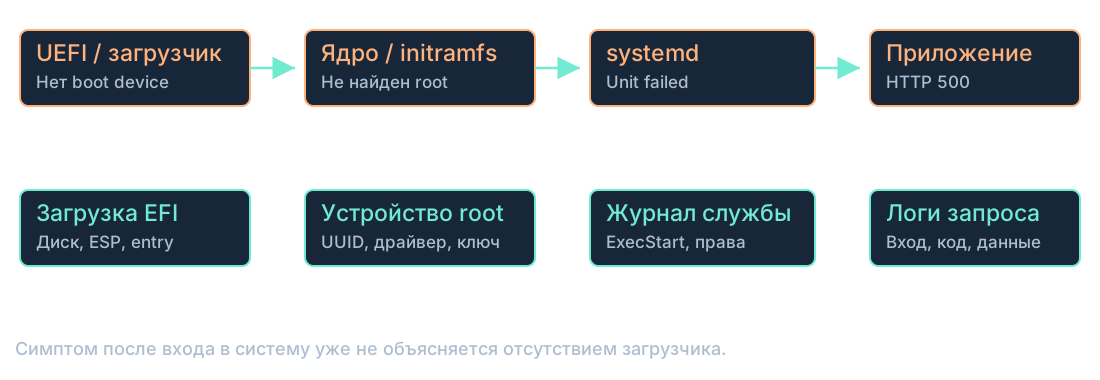
Дайте четыре коротких сообщения: no boot device, не найден UUID корня, failed unit и HTTP 500. Попросите поставить каждое на схему. Если firmware не находит загрузочную программу, смотреть журнал Python бессмысленно. Если initramfs не открыл root, systemctl из обычного сеанса ещё недоступен. Если система дошла до входа и одна служба failed, ядро и основной root уже работают: смотрим unit и журнал. Если API отвечает HTTP 500, сетевой путь как минимум дошёл до приложения; это не свидетельство сломанного GRUB. Идти по слоям не означает строго проверять всё с нуля: используем факты, уже содержащиеся в симптоме. На занятии не воспроизводим реальные повреждения bootloader: работаем с вымышленными карточками симптомов и объясняем, какой факт исключает гипотезу.
Аналогия: если касса печатает чек с ошибочной суммой, сначала проверяем расчёт, а не отсутствие электричества.
Практическое следствие: Нет. Ответ приложения доказывает прохождение многих нижних слоёв; начинаем с запроса и логов сервиса.
WSL2: путь запуска другой
Windows уже работает, когда вы открываете Ubuntu.
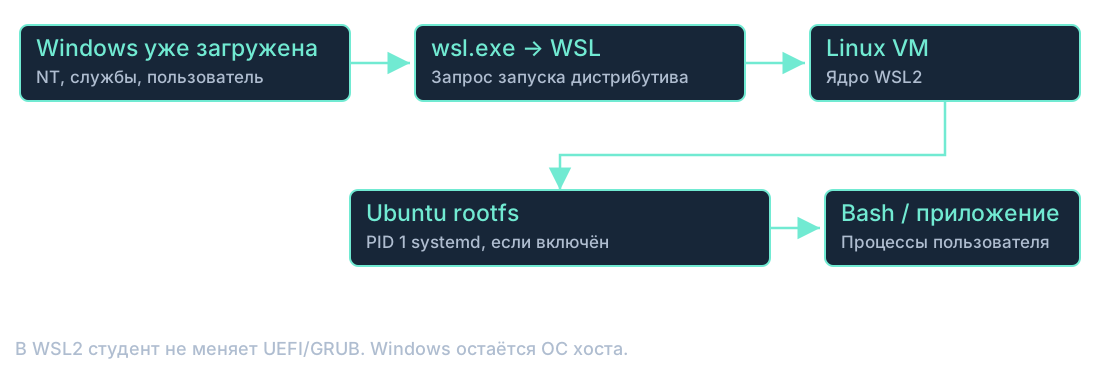
Команда wsl.exe просит инфраструктуру WSL запустить Linux-среду. WSL2 использует настоящее Linux-ядро в управляемой виртуальной машине, а Ubuntu добавляет rootfs, пакеты и пользовательские программы. При таком запуске студент не выбирает GRUB Ubuntu на физическом компьютере и не меняет EFI System Partition. Если для дистрибутива включён systemd, он занимает PID 1 внутри этой среды; связанные с WSL init-процессы выполняют интеграционные задачи. Проверяем факт командой ps -p 1 -o pid,comm,args, а не по названию окна. Наличие systemd не означает, что среда переживёт выключение Windows или wsl --shutdown. Microsoft отдельно отмечает: systemd-службы сами по себе не удерживают WSL instance живым. Для занятий этого достаточно, для постоянного сервера требуется другое решение.
Аналогия: отдельный офис внутри уже работающего бизнес-центра. Это настоящая среда, но её питание и время жизни зависят от хоста.
Практическое следствие: Нет. Ядро запущено инфраструктурой WSL2, а не обычной цепочкой загрузки отдельной Ubuntu на PC.
Три ОС: одинаковые роли, разные механизмы
Сравниваем firmware, ядро и службы; не называем macOS Linux.
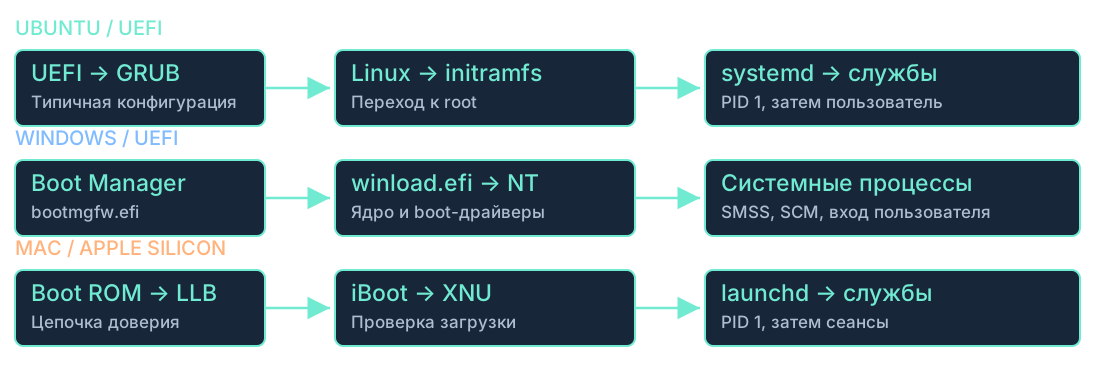
У Windows в типичной UEFI-загрузке firmware запускает Windows Boot Manager; winload.efi загружает NT-ядро и ранние драйверы. Затем появляются системные процессы и инфраструктура служб, в том числе Service Control Manager, и пользовательский вход. Эта строка не рисует весь граф Windows: SMSS, wininit и logon имеют свои роли и зависимости. Для Mac с Apple silicon аппаратная цепочка начинается с Boot ROM, затем участвуют LLB и iBoot с проверками доверия и политики загрузки; стартует XNU. Launchd управляет пользовательской системой служб и является PID 1. Intel Mac имеет другую firmware-цепочку, поэтому нельзя показывать Apple silicon как универсальную загрузку любого Mac. Linux, NT и XNU реализуют похожие задачи управления ресурсами, но используют разные API, драйверы и форматы приложений.
Аналогия: у зданий есть вход, электросистема и диспетчер, но схемы подключения и регламенты различаются.
Практическое следствие: Нет. Нужна конфигурация соответствующего менеджера и проверка конкретного приложения.
Что происходит при чтении файла
Приложение обращается к ядру; shell не читает диск за каждую программу.
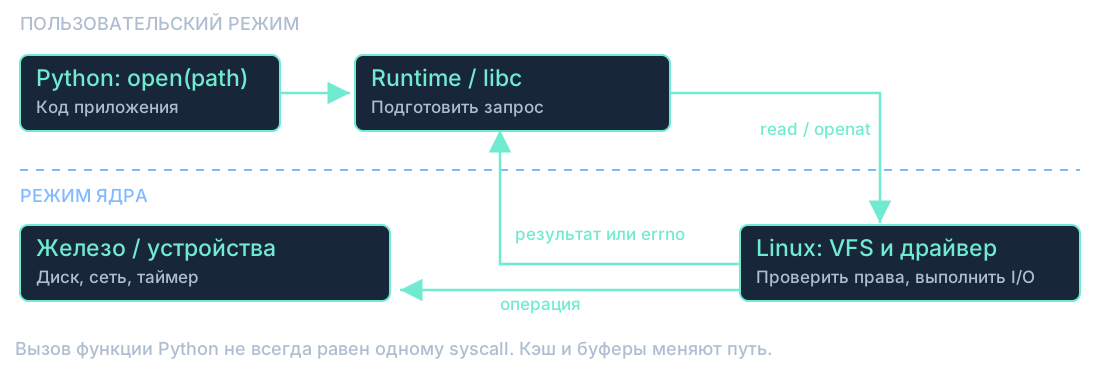
Python open — высокоуровневая операция. Runtime и библиотечные функции в нужный момент делают системный вызов: например, openat или read. Выполнение переходит через контролируемую границу из пользовательского режима в режим ядра. Ядро разрешает путь, проверяет доступ, использует файловую систему и при необходимости драйвер; результат или код ошибки возвращается приложению. Не путайте режим CPU с sudo: привилегированный пользовательский процесс тоже не получает право произвольно выполнять код ядра. Далеко не каждый вызов Python приводит к I/O: данные могут быть в буфере или кэше. Терминал лишь показывает интерфейс ввода/вывода; shell разбирает команду и запускает программу, которая затем самостоятельно запрашивает ресурсы. Для наблюдения используем узкий strace на собственном коротком процессе, не трассируем чужие приложения.
Аналогия: даже директор заказывает выдачу через складскую систему. Аналогия не описывает переключение режима процессора.
Практическое следствие: Права пользователя и режим CPU — разные вещи. Доступ к ресурсам идёт через интерфейсы ядра.
POSIX: общий договор о поведении
Стандарт описывает интерфейсы, а не устройство конкретного ядра.
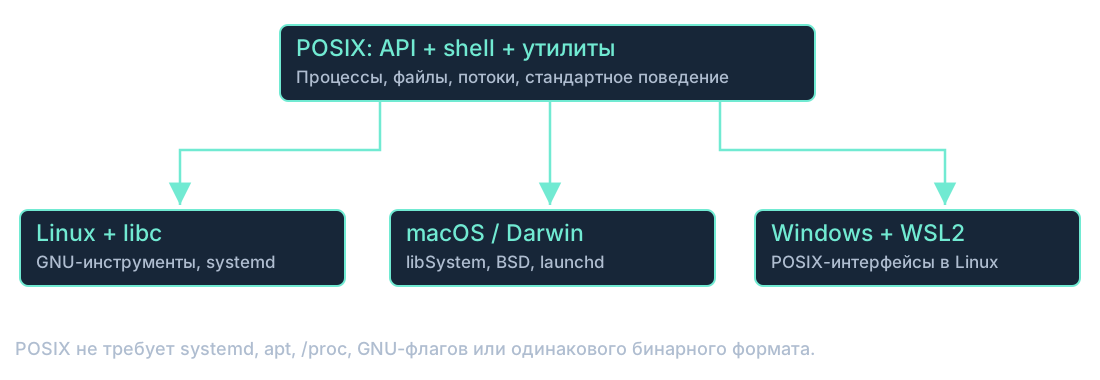
POSIX — семейство требований к интерфейсам ОС: процессам, файловым операциям, shell и утилитам. Благодаря общим соглашениям многие программы и скрипты проще переносить между Unix-подобными системами. Это не пакет, который устанавливают вместо Linux, и не описание внутреннего планировщика. Linux с библиотеками предоставляет многие POSIX-интерфейсы; macOS имеет Unix-происхождение и собственные реализации. Обычный Windows PowerShell не превращается в POSIX shell; Linux в WSL2 предоставляет отдельное совместимое окружение. Различайте поддержку интерфейса и формальную сертификацию конкретной версии ОС: надпись Linux сама по себе не является сертификатом. POSIX не требует systemd, apt, /proc или всех GNU-флагов. На слайде намеренно нет обещания полного равенства реализаций.
Аналогия: договор о форме розетки помогает подключать приборы, но не делает электростанции одинаковыми.
Практическое следствие: Первый использует широко доступный стандартный интерфейс; systemctl обращается к конкретному менеджеру systemd.
Переносимый исходник ≠ переносимый бинарник
API, команды, ABI и архитектуру процессора проверяем отдельно.
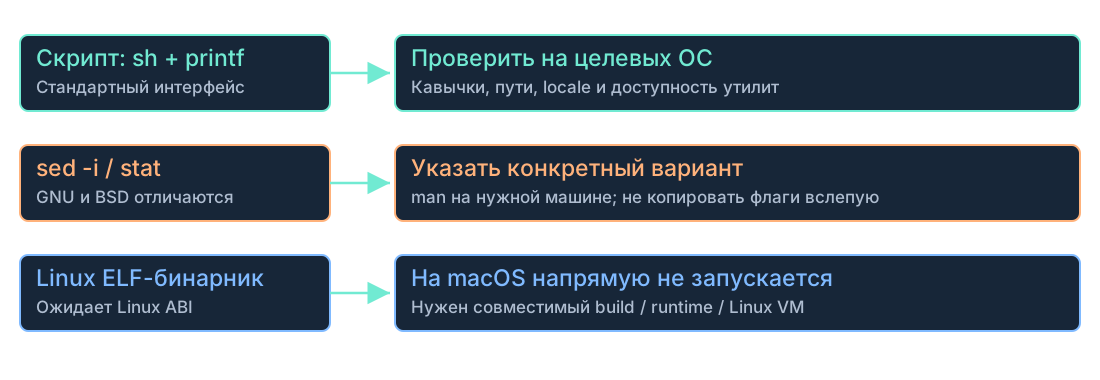
Даже когда исходник использует общие интерфейсы, готовый файл программы зависит от ABI, формата исполняемого файла, библиотек и архитектуры CPU. Linux ELF-файл нельзя просто считать приложением macOS Mach-O или Windows PE. POSIX облегчает перенос исходного кода, но не обещает единый бинарник. Скрипт зависит от доступного interpreter и поведения утилит: GNU и BSD версии stat и sed имеют разные флаги, locale меняет обработку текста, пути и регистр зависят от файловой системы. Практическая привычка: сначала определить слой несовместимости, затем выбрать правильный runtime или сборку. Для переносимого shell-опыта используем простые sh, printf и wc; GNU-расширения подписываем как Ubuntu. Контейнер Linux на Mac использует Linux-VM, а не магически делает XNU Linux-ядром.
Аналогия: рецепт можно приготовить на другой кухне, но детали одной плиты не обязаны подходить другой.
Практическое следствие: Нет. Интерфейс исходника и бинарный ABI — разные уровни совместимости.
Почему /proc и /mnt/c выглядят как папки
Единое дерево имён соединяет разные файловые системы.
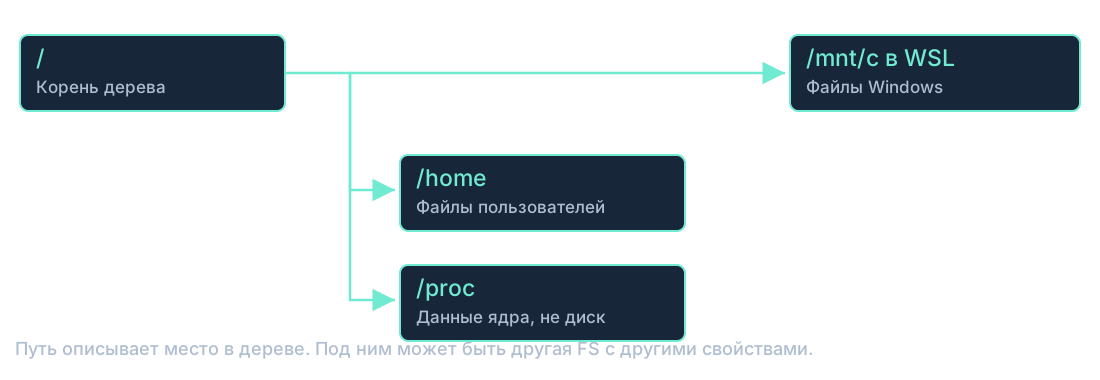
Корень / — начало дерева путей. Mount присоединяет другую файловую систему в выбранной точке этого дерева: поэтому часть /home может жить на отдельном устройстве, а /proc показывать динамические сведения ядра. /proc/PID не является папкой с резервной копией памяти на диске; объекты там формирует ядро. В WSL путь /mnt/c даёт доступ к файловой системе Windows с особенностями интеграции и метаданных. Одинаковый вид в ls не доказывает одинаковые права, производительность и правила имени. Для проекта выбираем ~/devops-course в Linux rootfs. Команда findmnt показывает структуру mount; она Linux-специфична. В macOS для просмотра монтирований используют mount и df, а /proc по умолчанию нет. Не даём задания перемонтировать системные файловые системы.
Аналогия: карта с адресами может вести и в склад, и в справочную службу. Единый адресный формат не означает одинаковый источник данных.
Практическое следствие: Их представление формируется ядром; это виртуальная файловая система.
LiveUSB: корень системы можно собрать без установки
Read-only образ и слой изменений дают обычное дерево файлов.
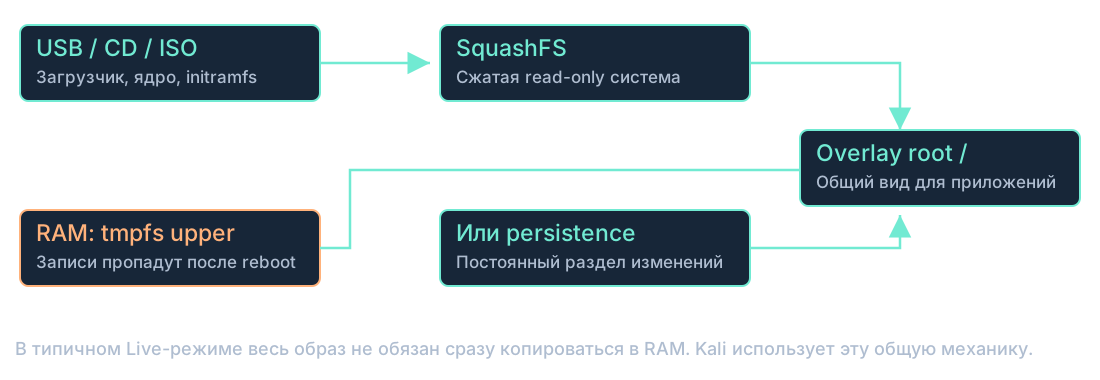
Носитель содержит загрузочные компоненты, ядро, раннюю среду и образ пользовательской системы. В распространённом Live Linux базовая система находится в сжатом SquashFS; OverlayFS объединяет её с writable-слоем. Изменение файла попадает в верхний слой, а исходный образ остаётся неизменным. Если верхний слой находится в RAM, изменения исчезнут после выключения; persistence хранит их на специально настроенном постоянном носителе. Режим copy-to-RAM может заранее скопировать образ, но он не обязателен: часто нужные блоки читаются с USB по мере использования и кэшируются. Поэтому фраза «всё целиком вгружается в оперативку» слишком груба. Kali Live использует общую Linux-механику, а не особое хакерское ядро. Live-среда удобна для восстановления файлов, проверки железа и работы с установленной системой, которая сейчас не загружена. Сам запуск Live не запрещает запись на внутренний диск: действия пользователя всё ещё могут его изменить.
Практическое следствие: Live — способ загрузки. Установка на диск, запуск VM, Live и WSL — разные способы предоставить среду.
Windows тоже запускает ремонтную ОС с носителя
WinPE и исторический BartPE решали задачу работы вне установленной Windows.
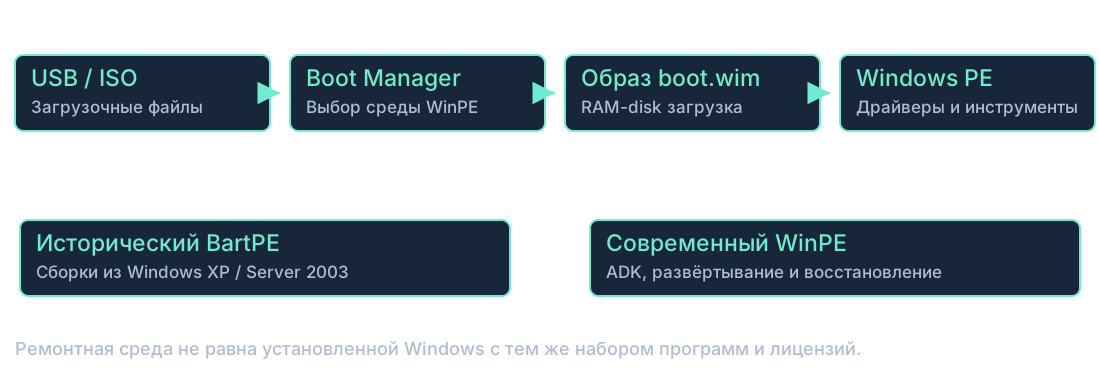
Windows PE — небольшая Windows-среда для установки, развёртывания и восстановления. Современная цепочка может загрузить boot.wim в RAM-disk, после чего работают драйверы, shell и ремонтные инструменты. Здесь сходство с Live Linux состоит в запуске самостоятельной среды с внешнего источника; детали образов и writable-слоя другие. В эпоху XP администраторы использовали сторонний PE Builder/BartPE и плагины для сборки загрузочной среды из файлов Windows XP или Server 2003. Это не доказательство, что обычная установленная XP автоматически полностью переносилась на любой CD. Историческую практику показываем как объяснение идеи, а не рекомендуем старую неподдерживаемую XP для работы. Ремонт установленной системы требует её корректного монтирования и понимания шифрования. Для практического показа достаточно ISO в отдельной VM: физическую флешку и основной диск студентов не перезаписываем.
Практическое следствие: Формат Windows WIM и Linux SquashFS/Overlay различается; обе среды могут работать независимо от основной установленной ОС.
Опыт: связать рисунок с наблюдением
ps -p 1 -o pid,comm,args
uname -srm
cat /etc/os-release
findmnt -T /proc
findmnt -T "$HOME"
# Optional Ubuntu trace of a new process
strace -e trace=openat,read,write /usr/bin/printf "hello\n"

lsblk -f
findmnt
cat /proc/cmdline
lsmod | head
# Read-only device inspection when pciutils is installed
lspci -k
Разложите карточки «нет boot device», «не найден root», «failed unit», «HTTP 500» по стадиям. Объясните, почему WSL2 не проходит через GRUB студента. Сравните uname и PID 1, не меняя загрузку. Ubuntu: для необязательного strace понадобится sudo apt install strace. Mac: uname -srm; ps -p 1 -o pid,comm,args; mount; df -h. Windows PowerShell: Get-CimInstance Win32_OperatingSystem | Select-Object Caption,Version; Get-Process -Id $PID. Запуск Windows-команд выполняется отдельно от Ubuntu.
Рассмотрите Live-образ в отдельной VM. Найдите mount корня и writable-слой, создайте временный файл, после перезагрузки проверьте сохранение. Persistence — отдельная демонстрация; не используйте dd с диском ноутбука.
Источники подробного разбора
- Документация
- Документация
- Документация
- Документация
- Документация
- Документация
- Документация
- Документация
- Документация
- Документация
- Документация
Пара 3: Shell, имена файлов и текстовые утилиты
Подробный разбор: Shell, имена файлов и текстовые утилиты
Terminal, shell и утилиты — три разных слоя
Shell превращает командную строку в запуск с аргументами и окружением.
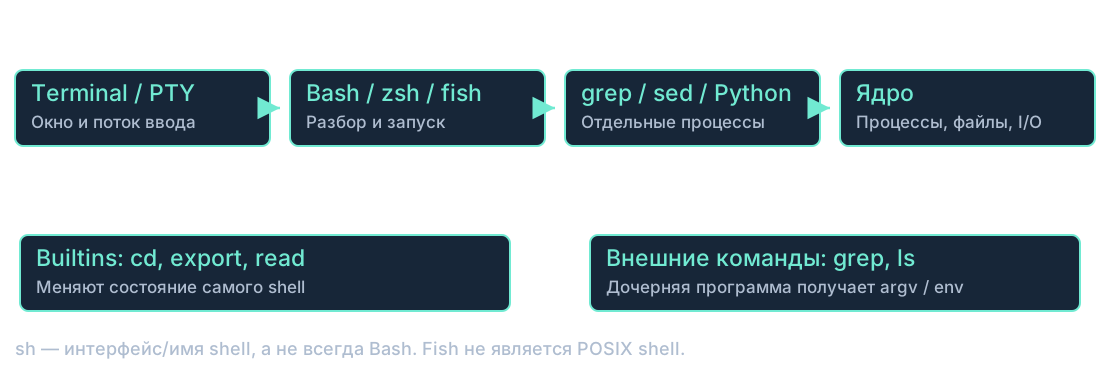
Terminal или terminal emulator обеспечивает взаимодействие через псевдотерминал. Bash, zsh, dash, fish — программы, интерпретирующие команды. POSIX sh задаёт переносимый интерфейс, но /bin/sh не обязан быть Bash: в Ubuntu часто используется dash. Bash добавляет собственные конструкции; zsh тоже имеет особенности, fish не стремится быть POSIX shell. Shebang #!/usr/bin/env bash выбирает interpreter для исполняемого скрипта, а запуск bash script.sh выбирает его явно. Команда cd обычно builtin: дочерний процесс не мог бы изменить текущий каталог родителя. Export меняет окружение будущих детей; обычное присваивание shell-переменной не всегда экспортируется. Alias — удобство интерактивного shell, а не надёжная dependency скрипта. PATH содержит каталоги для поиска внешних программ; command -v помогает увидеть реальное разрешение имени.
Практическое следствие: Кавычки, expansion и разбиение argv происходят до исполнения утилиты. На Mac интерактивный zsh и системный старый Bash — разные среды.
Файл .env скрыт только от обычного списка
В Linux точка — соглашение об имени, а не особый секретный тип файла.
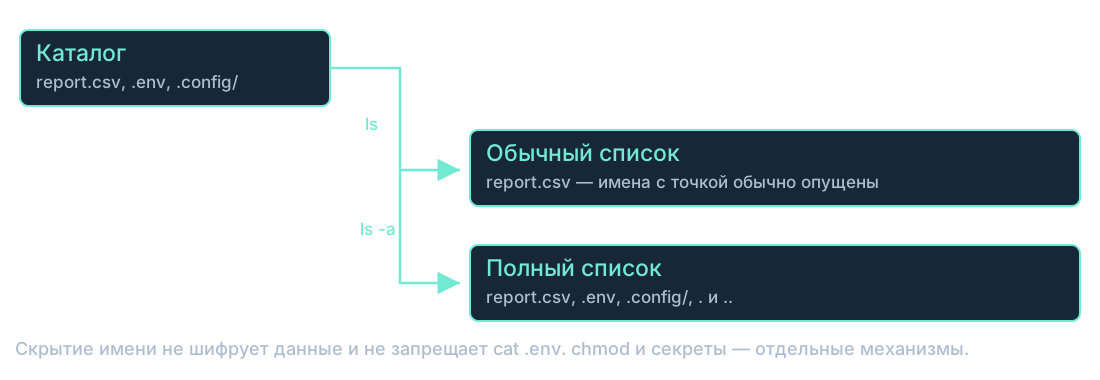
У имени .env нет автоматического запрета чтения: ls без -a обычно не показывает имена, начинающиеся с точки, но cat .env читает их при разрешённом доступе. . — текущий каталог, .. — родительский; это специальные записи, а не обычные пользовательские файлы. .config хранит пользовательские настройки по распространённому соглашению XDG; .bashrc и .zshrc относятся к соответствующим shell. Windows имеет отдельный атрибут hidden, поэтому похожее отображение достигается другим механизмом. Gitignore тоже не защищает секрет: он влияет на выбор неотслеживаемых файлов, но уже закоммиченный .env остаётся в истории. На практике применяют доступ по правам, разделение конфигурации и секретов, исключение из репозитория и ротацию случайно раскрытого секрета. Не ставьте chmod 777 ради чтения конфигурации.
Практическое следствие: ls -a показывает скрытые имена; ls -A опускает специальные записи . и .. Hidden не означает encrypted или unreadable.
/etc, /var, /usr, /tmp: роли каталогов
По роли данных можно выбрать место хранения и область диагностики.
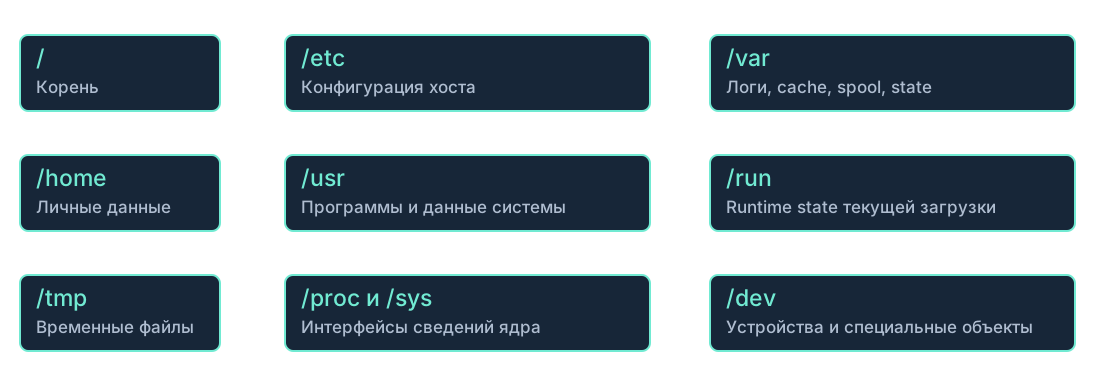
/etc содержит конфигурацию конкретного хоста; современный смысл важнее спорной расшифровки имени. /usr содержит установленный userland: программы, библиотеки и общие данные. /var предназначен для изменяемых данных — журналов, очередей и состояния приложений. /home содержит домашние каталоги; /root — домашний каталог root, а не синоним /. /run хранит состояние текущей загрузки; /tmp — временные файлы. /proc и /sys — интерфейсы виртуальных файловых систем со сведениями ядра, /dev — специальные объекты устройств. На merged-/usr системах /bin и /sbin могут быть ссылками внутрь /usr, поэтому старый рисунок «каждый каталог отдельный диск» неверен. FHS описывает соглашения, но конкретное приложение или контейнер может выбирать другое размещение. Всегда проверяем эффективный config и mounts.
Практическое следствие: Настройки, код, runtime state и пользовательские данные имеют разные сроки жизни и требования к резервному копированию.
grep, sed и awk решают разные задачи
Текстовый поток можно отобрать, преобразовать и разобрать без изменения оригинала.
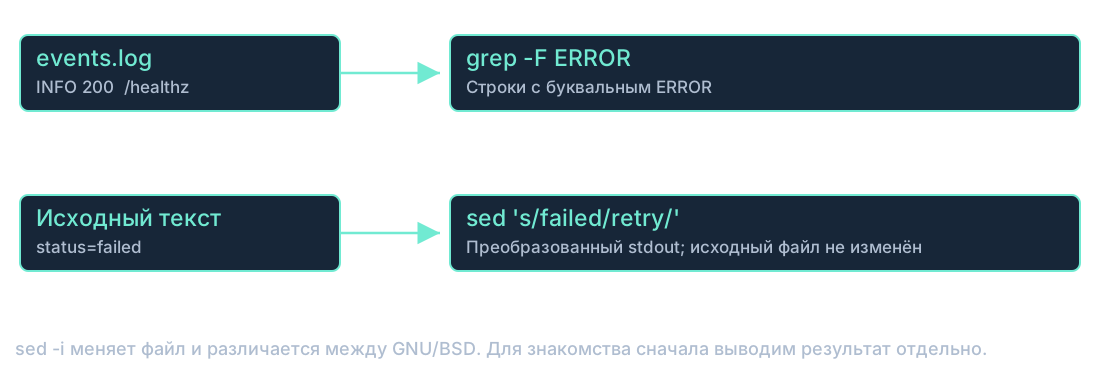
Grep выбирает строки по совпадению. -F ищет буквальный текст, -E использует расширенное регулярное выражение, -n добавляет номер строки. Sed применяет команды к потоку: s/old/new/ меняет первое совпадение в строке, флаг g — все подходящие совпадения. Без -i результат идёт в stdout, исходный файл сохраняется. Awk работает с записями и полями, умеет фильтрацию и вычисления; его стандартное разделение по whitespace не является полноценным CSV-парсером с кавычками. Sort упорядочивает строки, uniq объединяет соседние одинаковые, поэтому для полного подсчёта обычно нужны sort | uniq -c. Locale влияет на порядок и классы символов; LC_ALL=C полезен, когда нужен определённый байтовый порядок. GNU/BSD варианты флагов различаются. Для JSON выбираем JSON-парсер, а не пытаемся извлечь вложенную структуру регулярным выражением.
Практическое следствие: Фильтрацию и преобразование сначала выводим в новый файл; sed -i используется после проверки и с учётом различий GNU/BSD.
Опыт: связать рисунок с наблюдением
mkdir -p ~/devops-course/text-demo
cd ~/devops-course/text-demo
printf "INFO status=ok\nERROR status=failed\n" > events.log
printf "local-setting\n" > .settings
ls
ls -a
grep -n -F ERROR events.log
sed 's/failed/retry/' events.log
awk '{print $1}' events.log
command -v sh bash grep sed
Сохраните отфильтрованные ERROR в отдельный файл, сравните оригинал и результат. Работающие команды не требуют sudo. Прочитайте man grep / man sed своей ОС перед использованием расширенных флагов.
Источники подробного разбора
Пара 4: Потоки — это реальные связи между процессом и ядром; VFS, загрузчик библиотек и память
Подробный разбор: Потоки — это реальные связи между процессом и ядром; VFS, загрузчик библиотек и память
Куда на самом деле пишет stdout
Shell настраивает дескрипторы перед запуском программы.
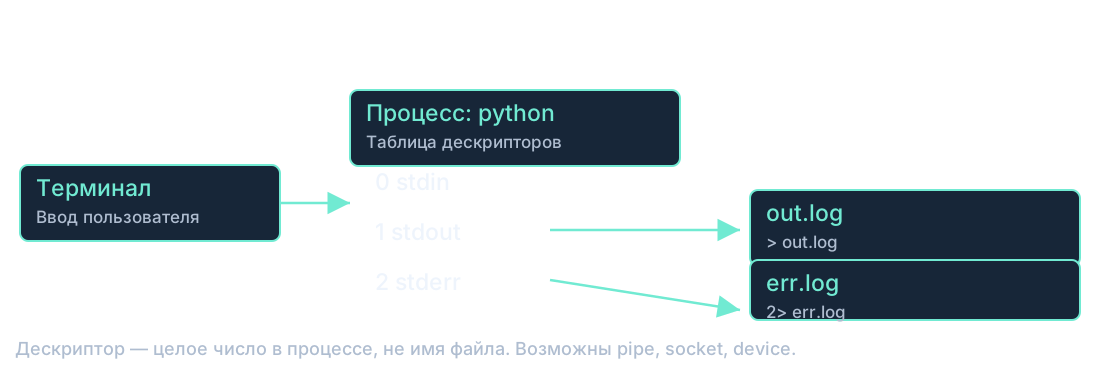
У процесса есть таблица открытых файловых дескрипторов. Традиционные номера 0, 1 и 2 означают stdin, stdout и stderr, но сами числа не говорят, какой объект подключён. Это могут быть терминал, обычный файл, pipe или socket. При python demo.py >out.log 2>err.log shell открывает объекты и связывает дескрипторы будущего процесса до выполнения программы. Программа пишет в 1, не выбирая экран. После fork ребёнок наследует дескрипторы, при exec открытые дескрипторы обычно сохраняются, если не помечены close-on-exec. Важно различать таблицу дескрипторов процесса и open file description ядра: разные дескрипторы могут ссылаться на одно описание и общий offset. Для первого занятия достаточно отследить маршруты байтов. Покажите print в stdout и stderr, затем откройте оба файла отдельно.
Аналогия: трубка с номером 1 подключена к выбранному приёмнику. Дескриптор не хранит содержимое файла.
Практическое следствие: Нет. Она пишет в stdout; shell уже настроил дескриптор.
Конвейер создаёт два процесса и канал
Pipe передаёт байты и заставляет ждать при пустом или полном буфере.
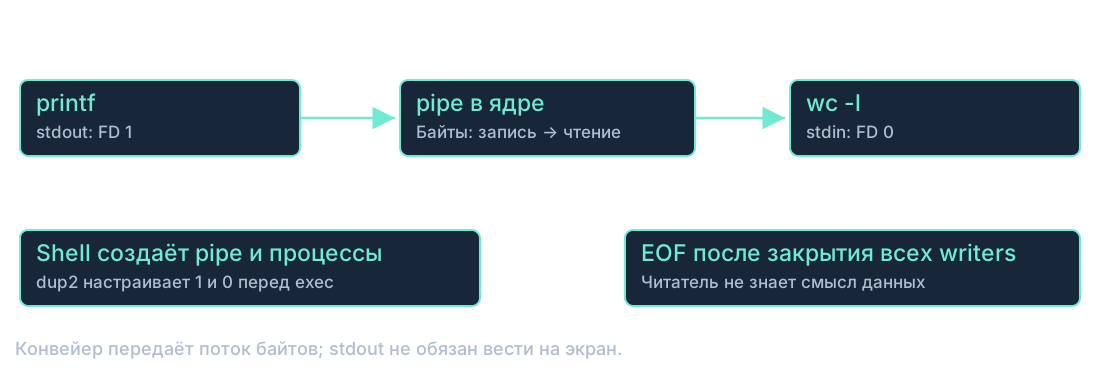
Shell создаёт pipe и организует процессы по обе стороны. Записывающий конец становится stdout первой программы, читающий — stdin второй. Это не передача имени файла и не запуск второй программы только после полного окончания первой: программы могут работать одновременно. Ядро хранит ограниченный буфер, поэтому быстрый writer может ждать медленного reader; пустой pipe заставляет reader ждать данных. После закрытия всех записывающих концов reader получает EOF. Если лишний writer-дескриптор остался открыт, читатель может продолжать ждать. В опыте printf печатает несколько строк, wc -l считает переводы строк. Просим объяснить, почему терминал видит результат wc, но не исходный поток printf. Детали dup2 даём в конспекте, код системного программирования на C не требуем.
Аналогия: две станции соединены узкой лентой. В действительности передаются байты без знания их смысловой структуры.
Практическое следствие: Когда все записывающие концы pipe закрыты и чтение возвращает EOF.
VFS даёт общий файловый интерфейс
Одинаковые open/read работают поверх разных файловых систем.
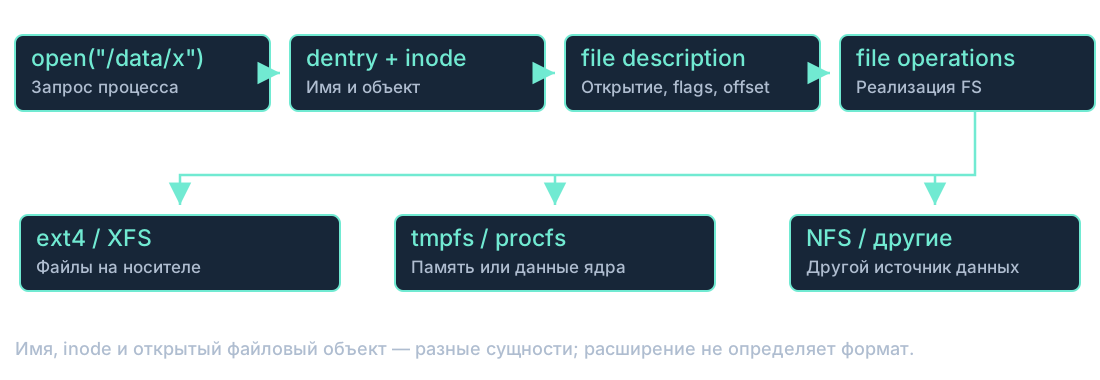
VFS — слой внутри Linux-ядра, объединяющий файловые интерфейсы. При разрешении пути dentry связывает имя с объектом, inode представляет сведения о самом объекте, а file description хранит состояние конкретного открытия, например позицию и flags. Дескриптор процесса указывает на открытый объект. Вызов read обращается к операциям конкретной файловой системы: ext4, tmpfs, procfs, NFS и другие имеют разные источники данных. Это объясняет и единое дерево, и то, почему «всё — файл» полезно как соглашение об интерфейсах, но не является буквальным описанием любого объекта ядра. Каталог хранит связи имён, hard link создаёт ещё одну связь с inode, symlink хранит путь. Расширение .csv не проверяет содержимое. Сеть и устройства могут быть доступны через дескрипторы, но операции и свойства отличаются от обычного дискового файла.
Практическое следствие: Путь и inode не тождественны. Разные имена могут указывать на один объект, а одно имя со временем — на разные объекты.
Удаление имени и освобождение данных — не один момент
Открытый файл может продолжать существовать после rm.
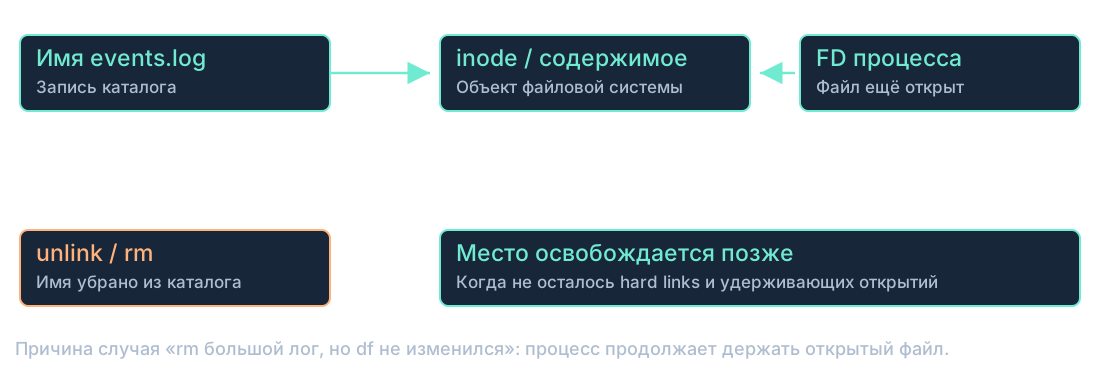
Unlink удаляет связь имени в каталоге. Если у объекта есть другие hard links или его держит открытый file description, данные ещё могут оставаться доступны и занимать место. Типичный инцидент: удалили большой журнал, а df не показывает свободное место; процесс продолжает писать в открытый, уже безымянный файл. Смотрят lsof +L1 или соответствующие /proc/PID/fd для доступных процессов, затем используют поддерживаемый способ переоткрытия журнала или штатный рестарт конкретной службы. Не убивают все процессы и не очищают /var/log целиком. Разница df и du также может происходить из-за mounts, недоступных каталогов, reserved space и других причин — один симптом не доказывает удалённый открытый файл. При учебной демонстрации используем маленький tempfile, который автоматически удаляется, не заполняем диск.
Практическое следствие: Для освобождения места нужно убрать удерживающие ссылки и открытия, а не повторить rm несуществующего имени.
Shared library загружает динамический linker
Библиотека содержит код; ABI задаёт правила связи с программой.
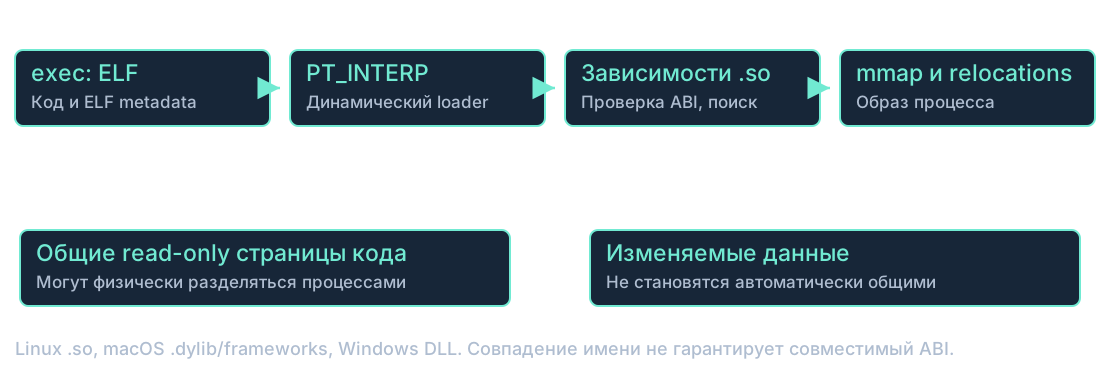
ELF-файл может указывать interpreter через PT_INTERP. При exec ядро организует начальное отображение, а динамический linker ищет необходимые shared libraries, проверяет ожидаемые зависимости и выполняет relocations. .so — Linux-библиотека, .dylib/framework — соответствующие механизмы macOS, DLL — Windows. Read-only страницы библиотечного кода могут разделяться между процессами, тогда как изменяемые данные каждого экземпляра остаются отдельными. Не все программы динамические: статическая сборка включает зависимости иначе. Ошибка «No such file or directory» для существующего ELF может означать отсутствующий interpreter, а не отсутствующий app. ABI mismatch нельзя исправлять скачиванием случайного libc.so. Ldd не выполняют на недоверенных файлах: безопаснее сначала читать metadata через readelf или objdump. Readelf также подходит для понимания архитектуры и dependencies.
Практическое следствие: Ubuntu: file /usr/bin/ls; readelf -l /usr/bin/ls; readelf -d /usr/bin/ls. Mac: file /bin/ls; otool -L /bin/ls.
RAM нужна для исполнения, но не всё копируется заранее
Виртуальная память отображает нужные страницы по мере обращения.
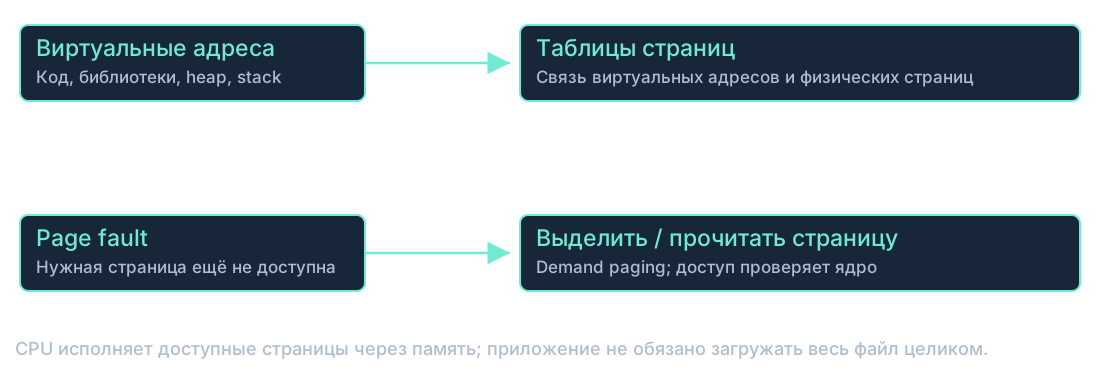
CPU работает с адресами памяти, а ОС и аппаратная MMU связывают виртуальные адреса с физическими страницами. Код, stack, heap и libraries составляют адресное пространство. Mapping файла не равен немедленному чтению всех его байтов в физическую RAM: demand paging позволяет загрузить нужную страницу при обращении. Page fault — механизм, который может быть нормальным; он не тождественен падению приложения. Ядро также держит page cache, чтобы повторные чтения файлов не требовали каждого обращения к диску. Поэтому занятая RAM не вся принадлежит уникальным данным приложений. VSZ описывает виртуальный размер, RSS — резидентные страницы с особенностями учёта shared mappings. Суммирование RSS всех процессов может учитывать общие страницы многократно. Не путайте RAM с диском, виртуальным адресным пространством или видеопамятью.
Практическое следствие: Исполняются доступные отображённые страницы. Большой файл модели может читаться постепенно или через mmap, а не обязательно целиком до старта.
Swap помогает вытеснять страницы, но не заменяет RAM
Cache, anonymous memory и swap участвуют в разных решениях reclaim.
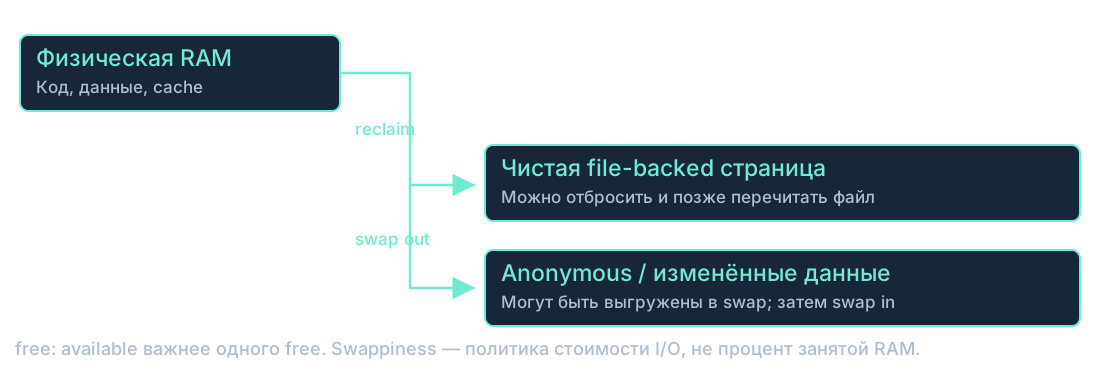
Чистую file-backed страницу ядро может удалить из RAM и затем перечитать из исходного файла. Для anonymous или изменённых страниц нужен другой способ сохранить содержимое, например swap. Swap может быть разделом, файлом или связанным с memory compression механизмом; zram и zswap не являются простыми синонимами дискового swap. Swappiness задаёт соотношение оценённой стоимости swap-I/O и файлового paging, а не процент RAM, при котором внезапно начинается swap. free показывает used/free/buff/cache/available: для оценки запаса полезнее available, учитывающий возможность reclaim. Постоянная интенсивная выгрузка/возврат страниц ухудшает отзывчивость; vmstat si/so полезны вместе с CPU, I/O и журналом. При нехватке памяти возможен OOM-kill с записью в kernel journal. Для демонстрации читаем показатели и не вызываем намеренный OOM на ноутбуке.
Практическое следствие: Ubuntu: free -h; swapon --show; vmstat 1 3. Mac: vm_stat; sysctl vm.swapusage; Activity Monitor показывает другую модель учёта.
/tmp — назначение каталога, tmpfs — тип хранения
Временное имя не гарантирует RAM и конкретный срок очистки.
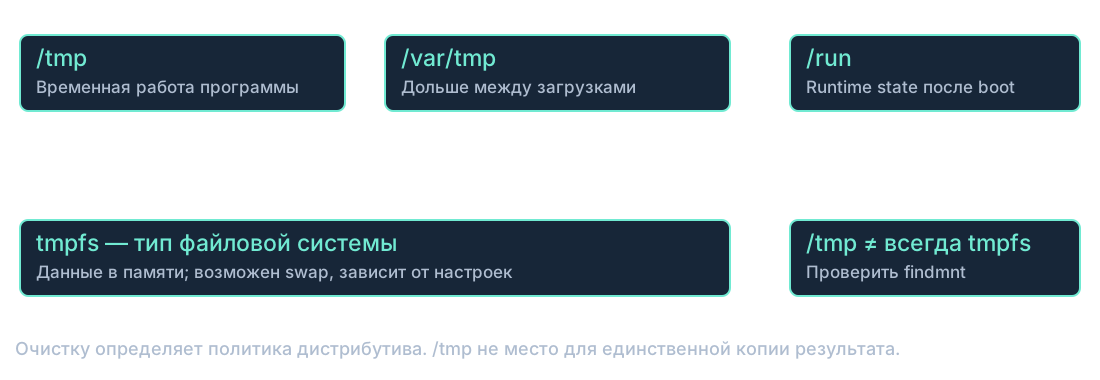
/tmp используется для временной работы и не годится для единственной копии результата. Его содержимое очищается согласно политике системы; /var/tmp предназначен для более длительных временных данных, /run — для runtime state текущей загрузки. Tmpfs хранит данные в виртуальной памяти и может использовать swap согласно конфигурации. /tmp может быть tmpfs или обычной дисковой файловой системой, поэтому проверяем findmnt -T /tmp, а не делаем вывод из имени. RAM-диск и tmpfs — не всегда один механизм. На общем /tmp действует sticky bit, но это не отменяет безопасного создания файлов: mktemp выбирает уникальное имя и помогает избежать подмены предсказуемого пути. Не очищайте чужие временные файлы ради лабораторной. Свою временную директорию программа должна удалять после использования.
Практическое следствие: findmnt -T /tmp показывает реальное хранение. tmpfs может обмениваться страницами со swap; после reboot данные не являются постоянным архивом.
Опыт: связать рисунок с наблюдением
printf "A\nB\n" | wc -l
python3 -c 'import sys; print("result"); print("diagnostic", file=sys.stderr)' >out.log 2>err.log
cat out.log
cat err.log

file /usr/bin/ls
# Optional when binutils is installed
readelf -l /usr/bin/ls | grep -F interpreter
readelf -d /usr/bin/ls | grep -F NEEDED
free -h
swapon --show
vmstat 1 3
findmnt -T /tmp
python3 lab/experiments/open_deleted.py
До запуска нарисуйте FD 0/1/2 для обеих программ. После запуска объясните, какие именно байты попали в каждый файл. Команды одинаковы в Ubuntu и macOS при наличии python3.
Свяжите VFS-схему с путём, descriptor и inode маленького tempfile. Сопоставьте free и ps без выделения больших массивов. Команды binutils устанавливаются заранее; readelf не является обязательной утилитой macOS.
Источники подробного разбора
Пара 6: Процесс изнутри: создание, выполнение, ожидание и завершение; IPC, наблюдение процессов и параметры ядра
Подробный разбор: Процесс изнутри: создание, выполнение, ожидание и завершение; IPC, наблюдение процессов и параметры ядра
Программа лежит на диске, процесс живёт в системе
Один и тот же код может иметь несколько независимых экземпляров.
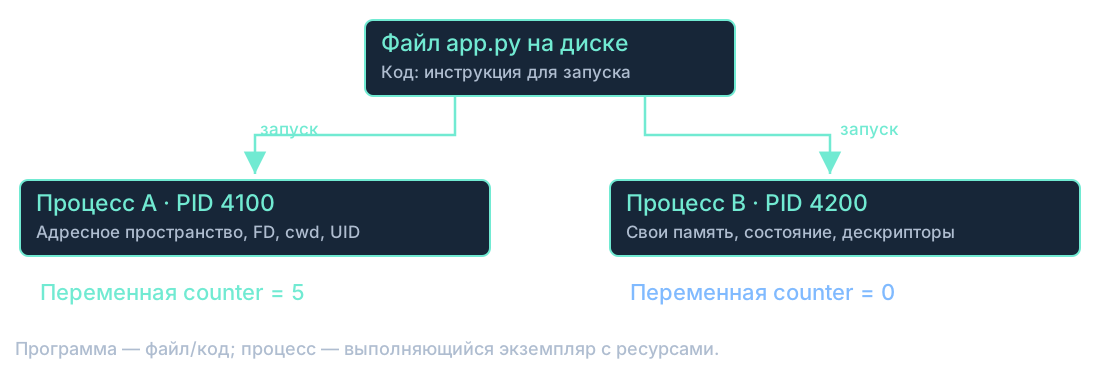
Процесс — экземпляр выполнения с PID, виртуальным адресным пространством, открытыми дескрипторами, текущим каталогом, окружением и идентичностью пользователя. Код программы на диске и память работающего процесса — разные объекты: изменение app.py не обязано изменить уже запущенный процесс. Если дважды запустить одну программу, у экземпляров будут разные PID и своё состояние, даже когда они читают тот же исходник. PID имеет смысл внутри пространства имён и может быть повторно использован после завершения; не воспринимайте его как вечный уникальный идентификатор. PPID показывает текущего родителя. Процесс имеет хотя бы один поток исполнения. Команда ps показывает снимок, поэтому результат может поменяться между проверкой и действием. Перед отправкой сигнала сверяем PID и команду собственного учебного процесса.
Аналогия: две копии рецепта готовят два повара с разными рабочими столами. Общие файлы всё ещё могут создавать конфликты.
Практическое следствие: Обычно нет: у разных процессов отдельные адресные пространства. Общую память нужно организовать отдельно.
fork, exec и wait делают разные вещи
Новый PID появляется при создании ребёнка; exec сохраняет PID.
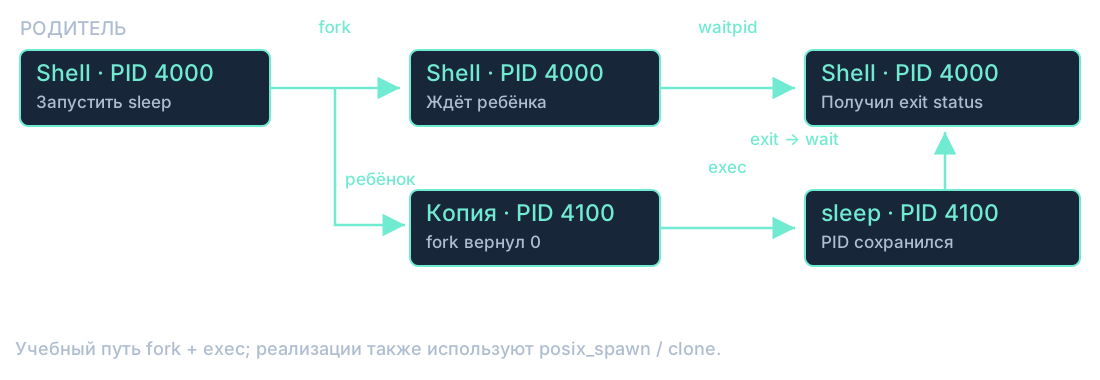
В учебной Unix-модели shell создаёт ребёнка через fork. В родителе возвращается PID ребёнка, в ребёнке — 0, поэтому один исходный участок кода продолжает работу по двум веткам. Ребёнок затем вызывает exec: ядро заменяет его образ программы, загружает новый код и исходное состояние. При успешном exec выполнение к прежнему коду не возвращается. PID остаётся тем же: это не создание третьего процесса. Родитель может ждать ребёнка через waitpid и получить статус завершения. Современные runtime и shell могут использовать posix_spawn или другие механизмы; наша цель — понять модель, а не обещать одинаковый syscall trace любого запуска. В демонстрации используем однопоточный Python и простую дочернюю команду, чтобы не переносить сложные ограничения fork многопоточных приложений в вводную практику.
Аналогия: созданному сотруднику назначили новую инструкцию; его табельный номер остался прежним. Память процесса заменяется намного строже, чем человеческая инструкция.
Практическое следствие: Нет. Изменяется выполняемый образ программы в том же процессе.
fork не обязан сразу копировать всю RAM
Copy-on-write откладывает копирование страниц до изменения.
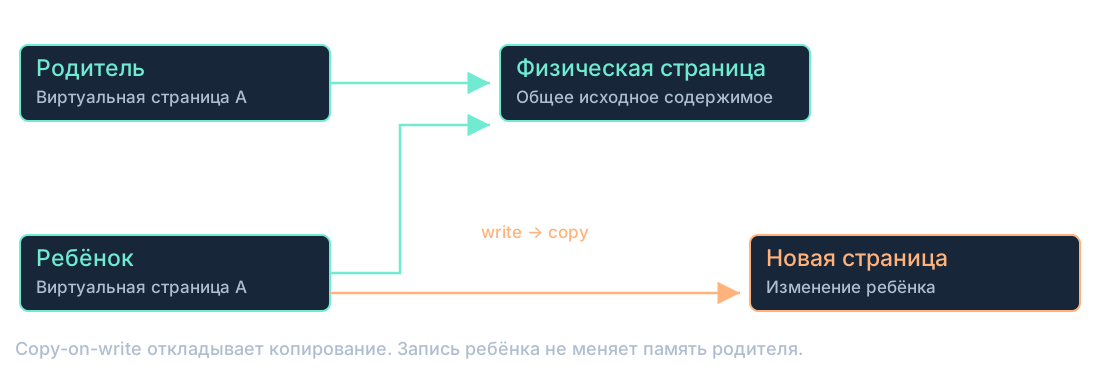
В Linux fork использует copy-on-write: виртуальные адресные пространства различаются, но неизменённые страницы могут ссылаться на одни физические данные. Когда одна сторона пишет в такую страницу, ядро организует отдельную копию. Это объясняет, почему логическая копия процесса не всегда немедленно удваивает всю фактическую память. Изменение переменной в ребёнке не меняет переменную родителя. Общие описания открытых файлов — другое дело: наследованные дескрипторы могут ссылаться на один open file description и общий offset. RSS двух процессов нельзя механически складывать и считать уникальной потреблённой RAM; в более глубоком анализе учитывают разделяемые страницы и PSS. На первом курсе по DevOps важнее понять предел аналогии «fork копирует всё», чем вычислять память по одному ps.
Аналогия: две версии документа сначала ссылаются на общие страницы, но правки создают отдельную страницу. Это не общий изменяемый список.
Практическое следствие: Нет при обычной частной памяти. COW сохраняет отдельность адресных пространств.
Процесс владеет ресурсами, потоки выполняют код
Потоки одного процесса разделяют память, поэтому нужен контроль совместных изменений.
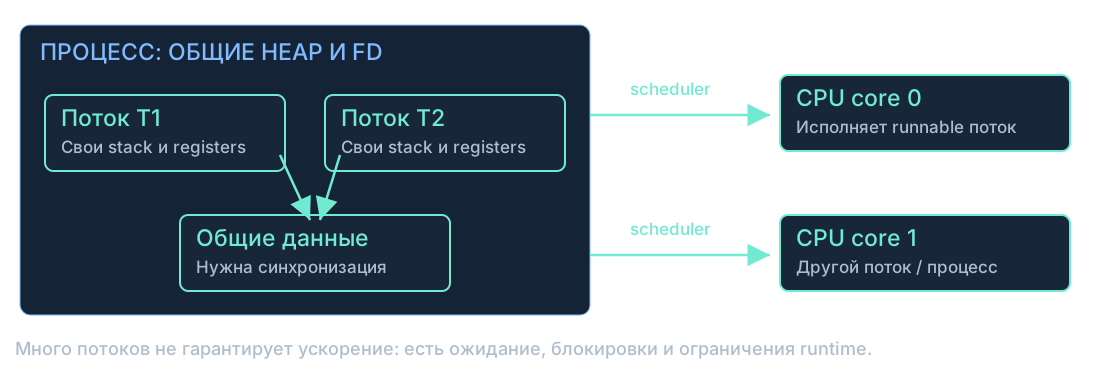
Потоки имеют собственный стек, регистры и контекст исполнения, но в пределах процесса обычно разделяют адресное пространство и таблицу дескрипторов. Два потока могут читать и изменять один объект — появляются гонки, которые не устраняются самим фактом «оба потока в Python». Планировщик распределяет runnable-потоки по CPU; ожидание сети или диска освобождает возможность выполнить других. На одном ядре параллельность ощущается через чередование, на нескольких ядрах возможна реальная одновременность. Число потоков не равно числу используемых CPU: runtime, блокировки, I/O и ограничения контейнера меняют картину. Версии CPython и режимы исполнения различаются, поэтому не формулируем вечное правило про любой Python. Для урока достаточно разделить процесс, поток и ядро CPU.
Аналогия: сотрудники работают за общим столом с общими бумагами. Несколько рук ускоряют не каждую операцию и требуют согласования.
Практическое следствие: Потоки могут ждать I/O, блокировки, runtime или CPU; есть накладные расходы.
Процесс может существовать и не использовать CPU
Ожидание, остановка и завершение — разные состояния.
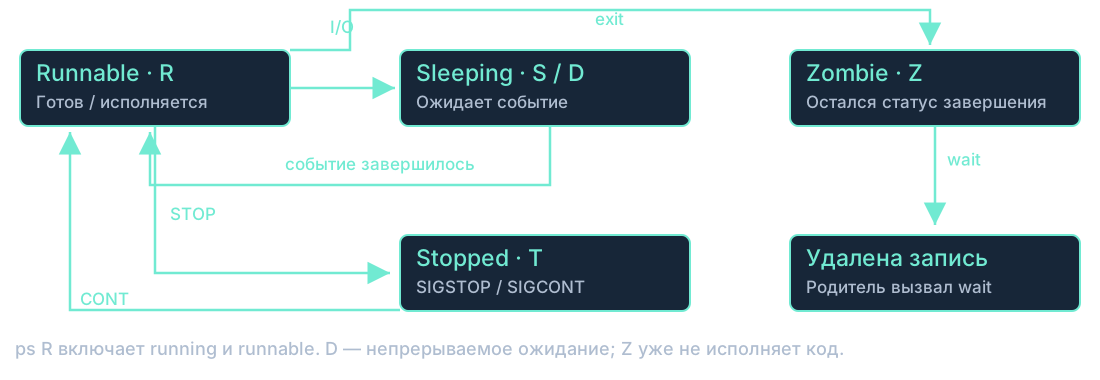
В Linux ps STAT показывает состояние и дополнительные признаки. R объединяет выполнение и готовность к исполнению; S означает прерываемое ожидание, часто таймер, сеть или ввод. D — непрерываемое ожидание, часто связанное с I/O; сигнал может не проявиться до выхода из этого ожидания. T — остановленное состояние: код пока не выполняется, но ресурсы остаются. Z — процесс уже завершился, а запись со статусом ещё ожидает родителя. Состояния меняются быстро, поэтому ps даёт лишь моментальный снимок. Сон не равен сбою, а CPU 0% не доказывает исправность: процесс может ждать навсегда. На опыте sleep обычно S; SIGSTOP переводит собственный процесс в T, SIGCONT разрешает выполнение снова. Не отправляем сигналы PID 1 или произвольным процессам группы.
Аналогия: работник ждёт доставку, а не исчезает из штата. Зомби уже закончил работу и хранится только учётная запись.
Практическое следствие: Нет. Он может штатно ожидать таймер или данные; проверяем ожидаемое поведение.
kill — запрос ядру отправить сигнал
SIGTERM позволяет обработку; SIGKILL не даёт программе выполнить очистку.
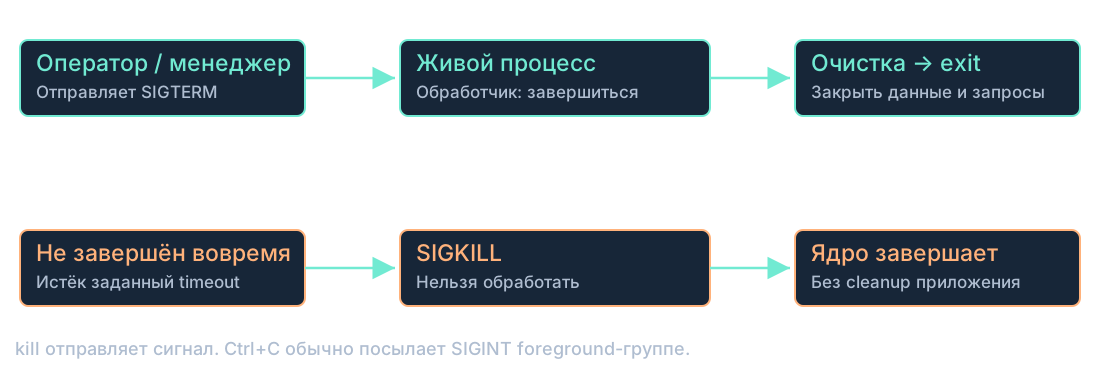
Сигнал — асинхронное уведомление процессу с определённым действием. SIGTERM обычно просит завершение; программа может установить обработчик, закончить текущую работу и выйти. Если обработчика нет, действует стандартное поведение. SIGKILL и SIGSTOP нельзя поймать или игнорировать. Ctrl+C в обычном терминале инициирует SIGINT для foreground process group, поэтому это не всегда сигнал только одному PID. Утилита kill не гарантирует, что процесс немедленно исчез: сигнал может быть обработан позже, а непрерываемое ожидание задерживает реакцию. Штатная остановка важна для сохранения данных, но сам SIGTERM ничего автоматически не сохраняет — очистка должна быть реализована приложением. В лабораторной начинаем с обычного TERM собственного sleep, затем ждём его через shell.
Аналогия: попросить закрыть магазин и выдернуть питание — разные действия. SIGKILL не является безопасной процедурой сохранения данных.
Практическое следствие: Она лишает приложение возможности штатно завершить работу и может скрыть причину отказа.
Зомби уже завершился, сирота потерял родителя
Лечение зависит от того, какая связь нарушена.
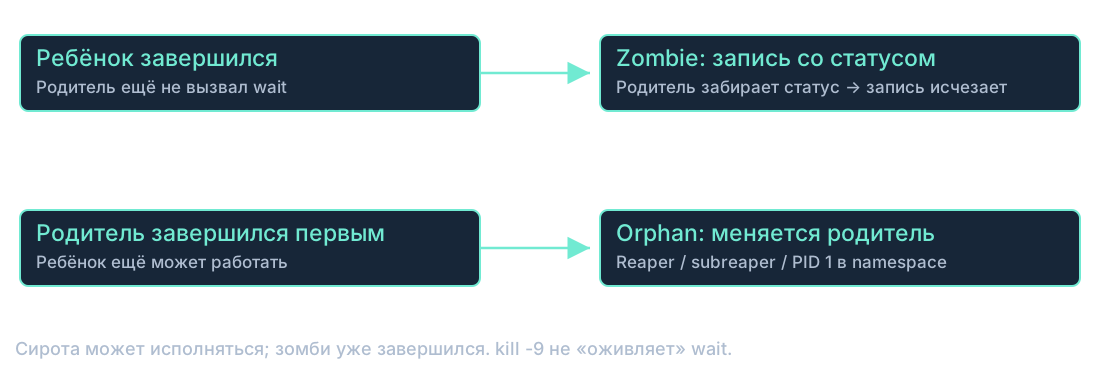
Когда ребёнок выходит, ядро сохраняет минимальную запись, чтобы родитель получил статус через wait. Пока этого не произошло, ps может показывать Z. Такой процесс уже не исполняет код; отправка kill не заменяет обязанности родителя собрать статус. Если первым завершился родитель, живой ребёнок становится сиротой. В Linux его подхватывает соответствующий reaper или subreaper, с учётом PID namespace; упрощение «любой сирота всегда получает host PID 1» неверно для всех контейнерных случаев. Сирота может продолжать полезную работу и не обязан стать зомби. Корректный менеджер процессов следит за детьми и собирает статусы. Поэтому PID 1 внутри контейнера должен правильно обрабатывать сигналы и дочерние процессы; небольшой init полезен, если приложение не выполняет эту роль.
Аналогия: зомби — незакрытая карточка законченной работы, сирота — продолжающий работу сотрудник с новым руководителем.
Практическое следствие: Нет. Это завершённый процесс с ещё не собранным статусом; сирота — другая ситуация.
POSIX-сигналы: уведомление и стандартное действие
Используем имена сигналов; их номера и обработка зависят от платформы.
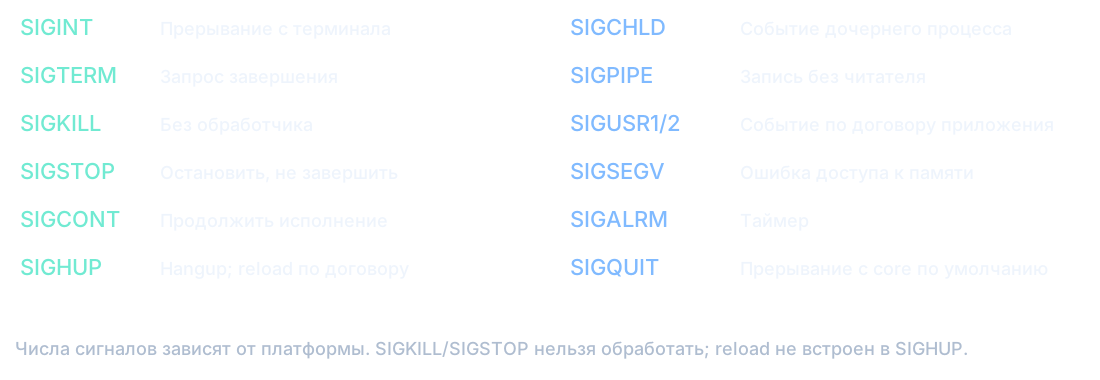
Сигнал имеет имя и стандартное действие, если приложение не установило собственный обработчик или не изменило disposition. SIGINT связан с обычным Ctrl+C, SIGTERM используется для завершения, SIGKILL принудительно завершает без обработчика, SIGSTOP приостанавливает, SIGCONT продолжает. SIGCHLD сообщает об изменении состояния детей: сбор статуса выполняется wait. SIGPIPE может возникнуть при записи в pipe/socket без получателя; программа может обрабатывать ошибку другим способом. SIGHUP исторически связан с hangup; многие daemon используют его для reload только по собственному соглашению. SIGUSR1/2 также имеют смысл, установленный конкретной программой. SIGSEGV связан с ошибкой доступа к памяти, SIGALRM — с таймером. Не все сигналы означают смерть процесса. Стандартные сигналы могут объединяться при повторной доставке, поэтому их нельзя воспринимать как надёжную очередь произвольного числа событий; real-time сигналы имеют другую механику. Номера Linux и macOS могут различаться, особенно у USR и CHLD. Shell kill -l показывает локальные имена/номера.
Практическое следствие: SIGHUP не перезагружает любую программу автоматически. SIGKILL и SIGSTOP невозможно поймать или игнорировать.
IPC: взаимодействие отдельных адресных пространств
Канал и формат сообщения определяют, как процессы согласуют работу.
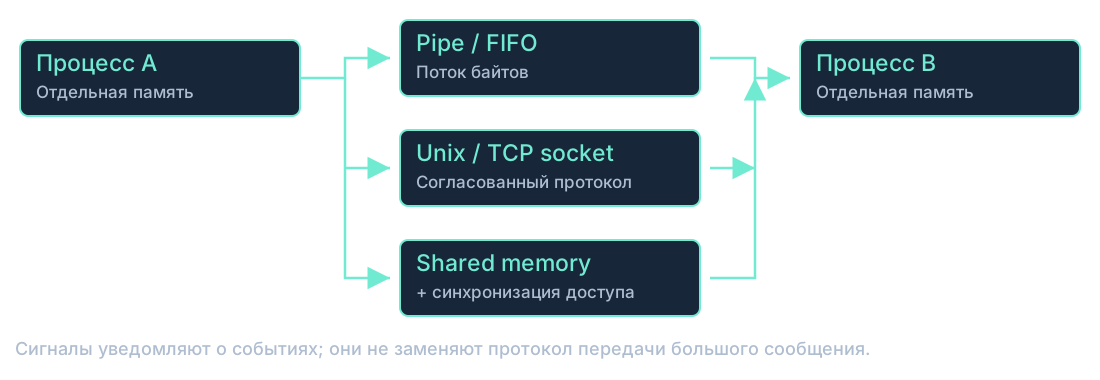
Pipe передаёт поток байтов, FIFO даёт похожий механизм с именем в файловой системе. Unix-domain socket связывает локальные процессы, TCP/UDP socket — процессы через сетевой стек. Shared memory позволяет отображать общие страницы, но требует locks, semaphores или другого протокола синхронизации, иначе появляются гонки. Сигналы удобны для уведомлений вроде terminate/reload; большие данные лучше передавать через явный канал. Файлы тоже используются для взаимодействия, но тогда надо определить атомарность записи и обнаружение изменений. Протокол сообщает, где заканчивается сообщение, какая версия формата используется и что делать при ошибке. TCP даёт поток без встроенных границ JSON: один write не гарантирует один read. В нашем API HTTP задаёт рамки запроса и ответа, а серверные процессы читают данные через socket.
Практическое следствие: Отдельная память процессов не исключает общую память; она появляется только при специально организованном mapping и согласовании доступа.
Socket — объект ядра и программный интерфейс
IP-адрес и порт относятся к сетевому варианту, Unix socket может быть локальным.
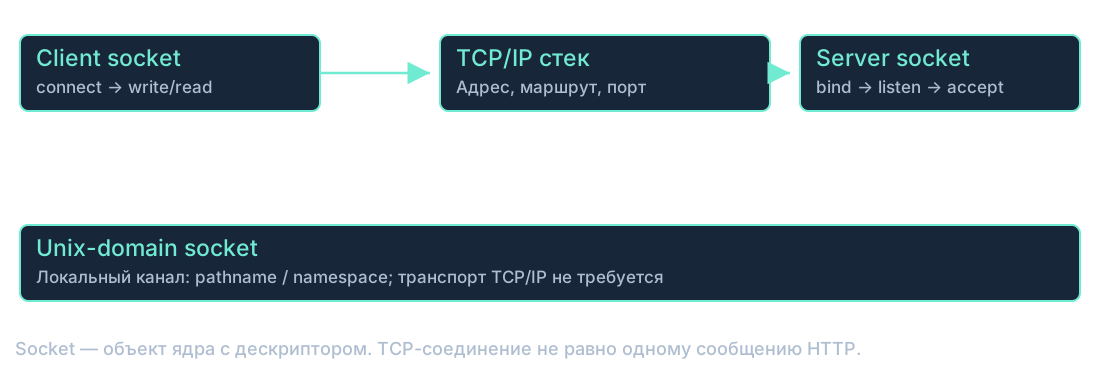
Сервер создаёт socket, делает bind к выбранному адресу и порту, listen переводит TCP socket в режим приёма соединений, accept возвращает отдельный socket для клиента. Клиент делает connect, затем стороны читают и пишут. Listening socket и connected socket — разные объекты. TCP-соединение идентифицируется адресами/портами и протоколом, поэтому множество клиентов может приходить на один порт 8000. UDP не использует тот же listen/accept lifecycle; это datagram транспорт. Unix-domain socket работает локально и может использовать pathname, например /run/service.sock, либо другие namespace-механизмы. Сокет доступен через file descriptor, но это не обычный файл с сохранённой историей пакетов. Ss показывает Linux sockets и их состояние; macOS обычно используют lsof. Bind 127.0.0.1 принимает локальные обращения, 0.0.0.0 расширяет область слушания и требует понимания сетевого доступа.
Практическое следствие: LISTEN подтверждает слушателя. HTTP 200 дополнительно подтверждает конкретный ответ приложения; это разные уровни проверки.
top и htop — начало диагностики
Загрузка CPU, ожидание I/O и нехватка RAM имеют разные признаки.
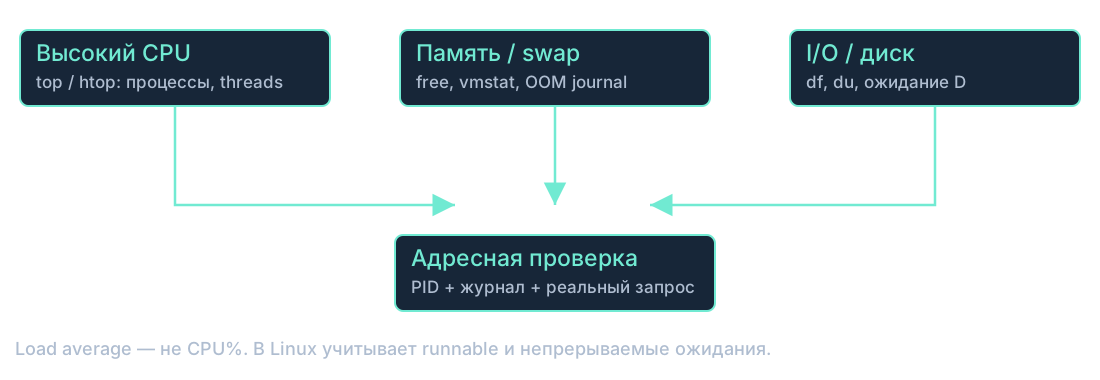
Top периодически показывает нагрузку, CPU, память и процессы. Htop предоставляет другой интерактивный интерфейс, дерево и удобный выбор колонок; его установка не меняет механизм планирования Linux. %CPU относится к интервалу и выбранному режиму отображения; многопоточный процесс может использовать больше одного ядра. Linux load average учитывает runnable и задачи в непрерываемом ожидании, поэтому не равен проценту CPU. Высокий load при низком CPU может быть связан с I/O, но нужно подтвердить это состояниями и измерениями. RSS, VSZ и swap нельзя трактовать как одно число «памяти программы». Процесс D требует исследования устройства и kernel journal, S часто штатно ждёт. Для API связываем PID, состояние, журнал и запрос, иначе даже красивый график не доказывает причину. Режим top -b удобен для сохранения короткого снимка.
Практическое следствие: Ubuntu: top -b -n 1; ps -eo pid,ppid,stat,pcpu,pmem,comm --sort=-pcpu; free -h; vmstat 1 3.
sysctl — настройки работающего ядра
Текущие значения и сохранённая конфигурация — разные состояния.
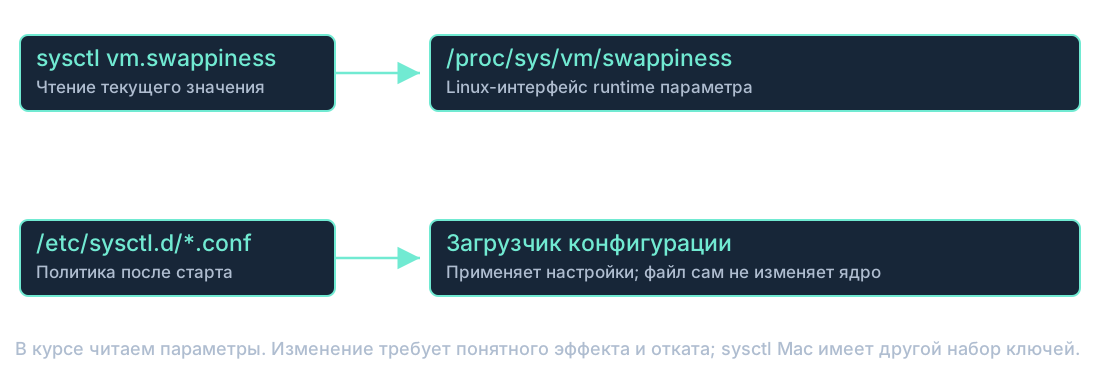
В Linux многие runtime-параметры доступны через /proc/sys. Sysctl читает или записывает эти значения; запись часто требует прав и может изменить сеть, память или безопасность немедленно. Файлы /etc/sysctl.d/*.conf описывают значения для применения системной инфраструктурой, но простое редактирование файла не равняется изменению текущего параметра. Не все свойства ядра настраиваются через sysctl, а набор ключей зависит от версии и сборки. На курсе используем чтение отдельных известных ключей, например vm.swappiness и net.ipv4.ip_forward. Копирование «ускоряющего набора sysctl» из блога не является диагностикой: нужны нагрузка, ожидаемый эффект и план возврата. Sysctl macOS имеет другой набор ключей и значения. Windows имеет другие механизмы конфигурации; Linux ключи туда не переносятся.
Практическое следствие: Чтение безопасно для наблюдения; изменение параметра — отдельное управляемое действие, а не универсальный ремонт.
Опыт: связать рисунок с наблюдением
python3 lab/experiments/process_lifecycle.py
sleep 30 &
pid=$!
ps -p "$pid" -o pid,ppid,stat,comm
kill -STOP "$pid"
ps -p "$pid" -o pid,ppid,stat,comm
kill -CONT "$pid"
kill -TERM "$pid"
wait "$pid"
printf "wait status: %s\n" "$?"

top -b -n 1 | head -n 15
ps -eo pid,ppid,stat,pcpu,pmem,comm --sort=-pcpu | head
ss -lnt
sysctl vm.swappiness net.ipv4.ip_forward
python3 lab/experiments/local_ipc.py
Перед опытом нарисуйте два PID и место exec. Сравните печать child-before-exec и child-after-exec: PID должен совпасть. Родитель получает exit status 7; сам учебный сценарий завершается успешно после проверки. В опыте sleep запишите S/T после сигналов; wait для TERM даёт ненулевой статус (численное представление shell может различаться). Работает в Ubuntu и macOS с python3. Запускайте блок в интерактивном Bash/zsh без режима set -e. Не сохраняйте PID для следующего занятия: его могли переиспользовать.
Снимите три коротких наблюдения собственного сервиса: PID/STAT, LISTEN и ответ HTTP. IPC-опыт использует socketpair и не открывает внешний порт. На Mac доступны ps, top, lsof; Linux sysctl ключи заменяются только после проверки документации.
Источники подробного разбора
- Документация
- Документация
- Документация
- Документация
- Документация
- Документация
- Документация
- Документация
- Документация
Пара 7: Путь пакета, firewall и режимы Wi-Fi
Подробный разбор: Путь пакета, firewall и режимы Wi-Fi
Пакет проходит маршрутизацию и hooks Netfilter
Локальный получатель, транзит и локальный отправитель имеют разные пути.
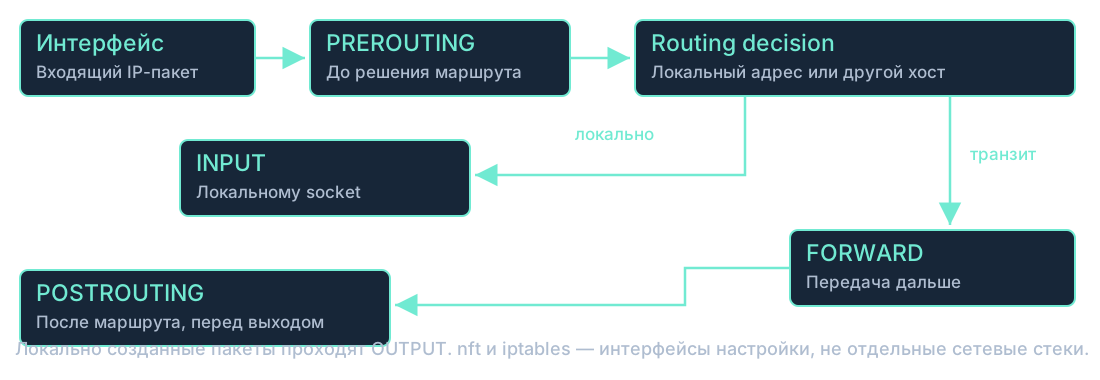
Входящий IP-пакет попадает в сетевой стек, проходит соответствующие hooks и решение маршрута. Для локального адресата важен INPUT, для пересылки через хост — FORWARD; локально сформированный пакет проходит OUTPUT, перед выходом участвует POSTROUTING. PREROUTING расположен до решения маршрута. Это упрощённая карта: конкретные priorities, families, bridge/ingress и connection tracking добавляют детали. Firewall проверяет правила в нужной точке, а NAT меняет адреса или порты; NAT не является синонимом ограничения доступа. Если процесс слушает только 127.0.0.1, открытие firewall не заставит его слушать внешний адрес. При таймауте отдельно проверяют наличие слушателя, route и filter, а DNS лишь определяет адрес. Правила на удалённом сервере без запасного доступа не меняем. Учебная демонстрация — схема и чтение имеющегося ruleset, а не очистка правил хоста.
Практическое следствие: Локальный HTTP-сервис нужен в INPUT-пути, router-трафик — в FORWARD. Адрес/порт приложения всё равно проверяются отдельно.
iptables и nftables — способы настроить правила
Важен реальный backend, а не только имя команды.
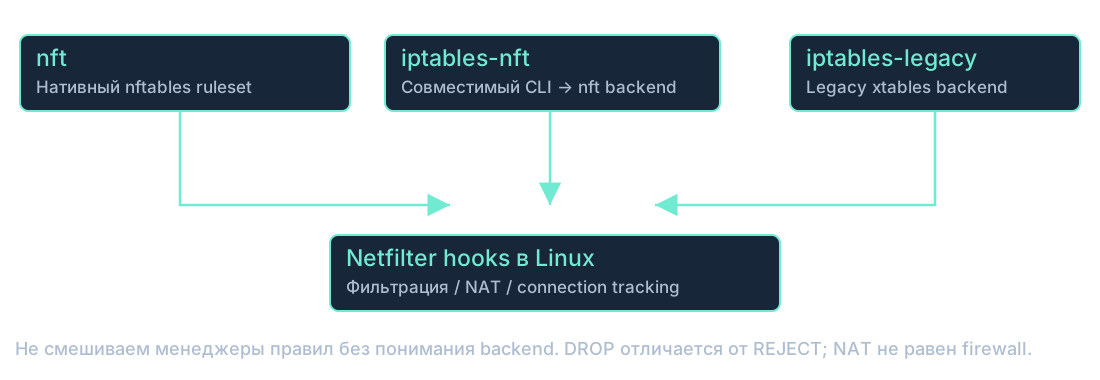
Netfilter — инфраструктура обработки пакетов в ядре. Iptables является историческим интерфейсом управления xtables; nftables даёт другой ruleset и nft CLI. На многих современных системах iptables-nft переводит знакомый синтаксис в nft backend, тогда как iptables-legacy обращается к legacy механизму. Поэтому iptables --version и nft list ruleset помогают выяснить, что действительно используется. UFW и firewalld — ещё один слой управления, который может генерировать правила; ручное изменение параллельно менеджеру может быть перезаписано. В nftables ruleset состоит из tables, chains и rules; base chain подключается к hook с priority и policy. DROP молча отбрасывает пакет, REJECT возвращает отказ по выбранному механизму. Stateful фильтрация использует состояние соединения, но понятие established не делает приложение доверенным. Пример конфигурации хранится в файле и проверяется в изолированной VM/namespace, без nft flush ruleset на ноутбуке.
Практическое следствие: Ubuntu: nft --version; iptables --version; sudo nft list ruleset — только чтение. WSL2 имеет также сетевые ограничения Windows-хоста.
wlo1 — имя интерфейса, managed — режим
Radio-возможности определяются PHY, драйвером и поддержанными сочетаниями.
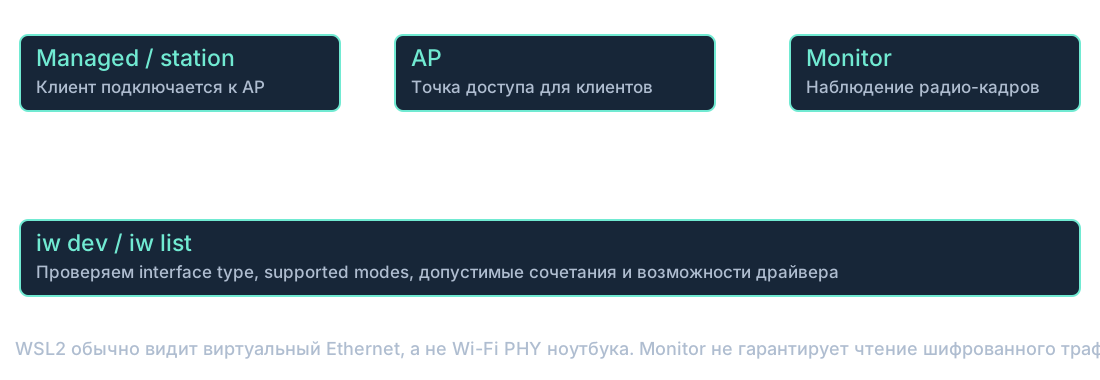
Predictable interface names вроде wlo1 или wlp2s0 обозначают интерфейс по правилам именования, а не режим «взлома» или тип firewall. Managed/station — Wi-Fi клиент, AP — точка доступа, monitor — получение радио-кадров в пределах возможностей адаптера. Iw dev показывает интерфейсы и type, iw list — capabilities PHY. Не каждый адаптер поддерживает monitor, AP или одновременные комбинации; виртуальная машина может не получить прямого Wi-Fi доступа. WSL2 обычно видит виртуальную сеть, поэтому iw может не показывать Wi-Fi PHY ноутбука. Monitor не равен promiscuous mode обычного Ethernet и не гарантирует расшифровку защищённого трафика. В занятии читаем режимы своего устройства и обсуждаем схему. Переключение рабочего Wi-Fi на monitor отключит обычное подключение; такую демонстрацию делают только на отдельном собственном адаптере, а не на сети аудитории.
Практическое следствие: Kali не создаёт аппаратную возможность monitor. Используется тот же Linux wireless stack и поддержка конкретного драйвера.
Опыт: связать рисунок с наблюдением
ip -brief address
ip route
ss -lnt
getent hosts example.com
nft --version
iptables --version
# Physical Linux with iw and a supported wireless adapter
iw dev
iw list | head -n 40
# Isolated user + network namespace; no host rules changed
unshare -Urn sh -c 'nft --check -f lab/experiments/firewall.nft && nft -f lab/experiments/firewall.nft && nft list table inet devops_demo'
Соберите путь собственного HTTP-запроса от curl до LISTEN. Firewall-пример применяется только внутри unshare -Urn, то есть собственного user/network namespace. Если user namespaces заблокированы политикой системы, используйте отдельную VM. Не выполняйте nft -f этого файла в обычном namespace хоста. В ruleset отдельная inet table, base chain INPUT, loopback, established/related и TCP 8000; policy drop блокирует остальное в изолированной среде. В WSL при отсутствии iw PHY запишите границу виртуальной среды; это не повод устанавливать Kali.
Источники подробного разбора
Пара 8: Пакеты, зависимости и совместимая конфигурация
Подробный разбор: Пакеты, зависимости и совместимая конфигурация
Менеджер пакетов связывает версии зависимостей
Пакеты системы, Python venv и контейнерный образ управляют разными слоями.
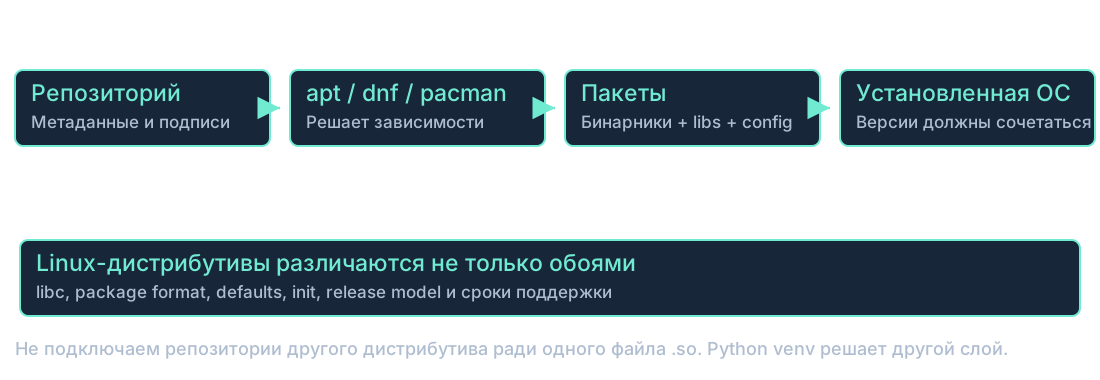
Apt получает metadata репозитория, проверяет доступные пакеты и решает dependencies; dpkg устанавливает отдельный deb, но не заменяет всей логики репозитория. Системный Python, libc и утилиты принадлежат пакетной системе, поэтому sudo pip способен нарушить ожидаемые версии. Venv отделяет Python-пакеты проекта, но не создаёт другую Linux libc. Pip freeze фиксирует часть Python-среды, а не версию ядра и системных библиотек. Контейнерный образ фиксирует пользовательскую среду иначе, но разделяет ядро хоста. Неправильный файл .so или пакет из другого дистрибутива может привести к missing symbols и ABI errors. Сначала определяют, какой компонент и runtime действительно запускаются: command -v, python -c import sys, file/readelf, package ownership. В конфигурации используют абсолютные пути, очевидную рабочую папку и явно заданные переменные, особенно при переходе к systemd.
Практическое следствие: Ремонт dependency начинается с определения активного interpreter и источника пакета, а не с установки всего подряд.
Опыт: связать рисунок с наблюдением
command -v python3
python3 -c 'import sys; print(sys.executable); print(sys.version)'
dpkg -S /usr/bin/ls
apt-cache policy python3
python3 -m venv .venv
.venv/bin/python -c 'import sys; print(sys.executable)'
Сравните системный interpreter и .venv; не меняйте системные пакеты через pip. На Mac package manager и ownership-команды отличаются.
Источники подробного разбора
Пара 9: systemd: от графа units до исправного сервиса; Логи ядра, служб и приложений
Подробный разбор: systemd: от графа units до исправного сервиса; Логи ядра, служб и приложений
Что делает systemd и что остаётся ядру
systemd организует пользовательские службы, ядро управляет ресурсами.
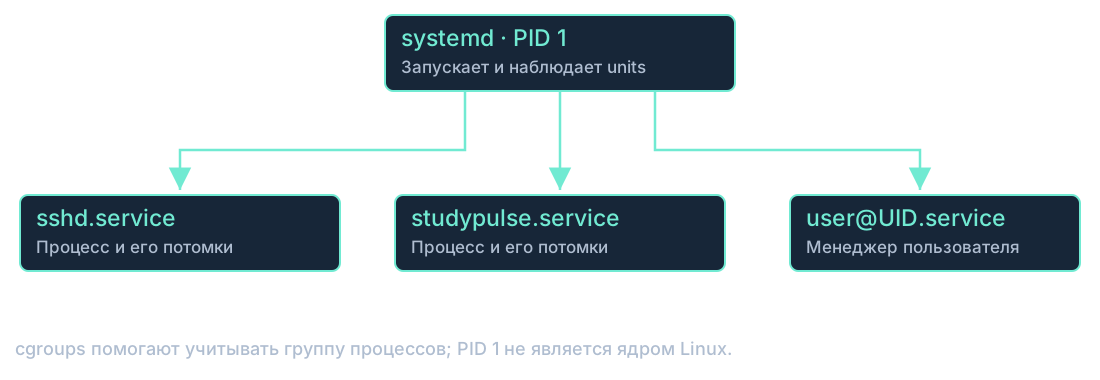
В Ubuntu systemd обычно является PID 1 системы: он запускает и наблюдает объекты пользовательской среды, собирает завершения процессов и организует остановку. Он не заменяет ядро и не планирует инструкции на CPU вместо Linux. Ядро предоставляет процессы, сигналы, файловые системы и cgroups; менеджер использует эти механизмы. Через cgroups можно учитывать не только один MainPID, но и потомков службы. Отдельный systemd --user управляет units конкретного пользователя. PID 1 имеет особую роль, поэтому не демонстрируем на нём kill. На схеме показаны связи управления, а не обещание, что каждый рабочий процесс навсегда остаётся прямым ребёнком PID 1: приложения могут создавать потомков и промежуточные процессы. Сервис запускать через менеджер удобнее, когда нужны наблюдение, журнал, политика остановки и воспроизводимая конфигурация.
Аналогия: диспетчер организует смены, инженерная система здания обеспечивает ресурсы. Менеджер не является электрической сетью.
Практическое следствие: Планировщик ядра. systemd задаёт организацию служб и может использовать ограничения ресурсов.
Unit — объект управления; service — процессная работа
target группирует, timer активирует, mount подключает файловую систему.
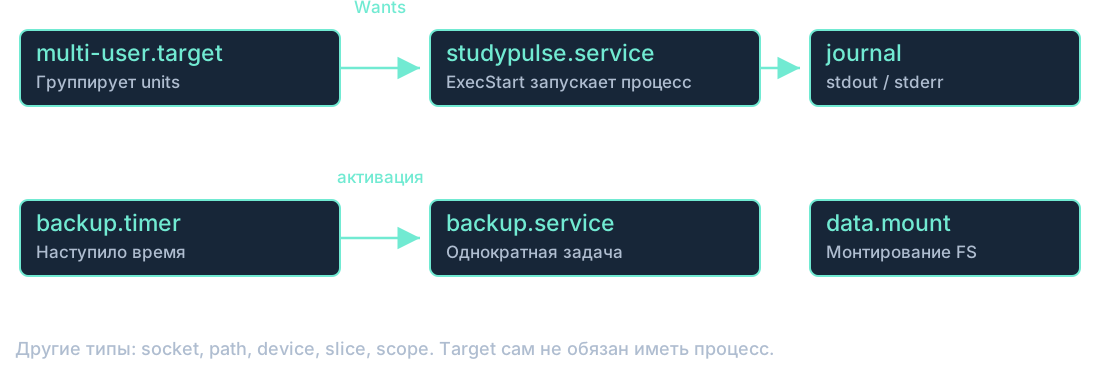
Unit — общий формат описания управляемого объекта. Service задаёт способ запуска и наблюдения процесса или задачи, target объединяет units в логическую группу, timer планирует активацию, mount представляет монтирование. Есть также socket, path, device, slice и scope. Target не является отдельной программой, которая должна висеть в ps. Журнал — отдельная инфраструктура: stdout и stderr службы могут поступать в journal согласно её настройкам. В нашем сервисе оставляем процесс в foreground: менеджеру не нужен самодельный фон через &. Секция [Unit] содержит общие связи, [Service] — параметры выполнения, [Install] — инструкции создания связей при enable. Показать эти три секции полезнее, чем просить запомнить десятки директив без их роли.
Аналогия: расписание включает отделы, дежурства и события, но не каждое поле расписания — отдельный работник.
Практическое следствие: Нет. Это группирующий объект менеджера, а не обязательный процесс.
Requires и After отвечают на разные вопросы
Нужен ли другой unit — и в каком порядке выполнять задания.
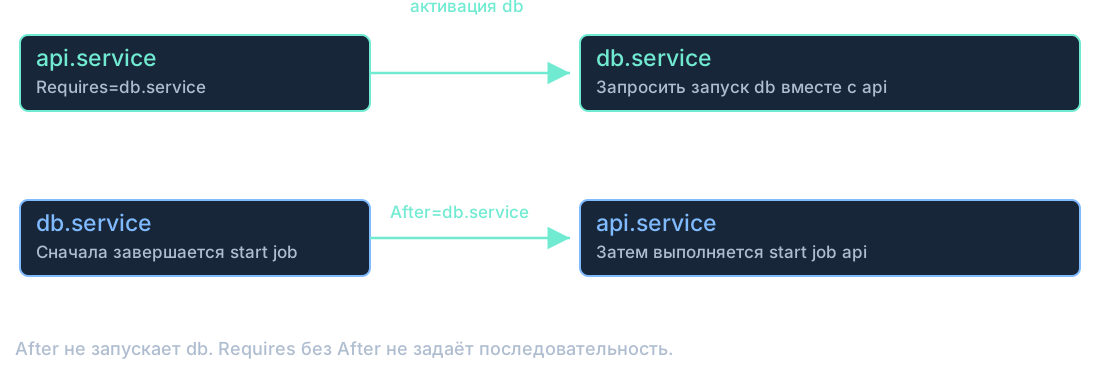
Requires=db.service включает db в транзакцию активации; After=db.service задаёт порядок, если оба unit участвуют. After сам по себе не запускает db. Requires без ordering не требует сначала закончить запуск db, поэтому обе службы могут стартовать параллельно. Для учебного обязательного подготовительного шага используем Requires вместе с After. Если подготовительный unit не сможет активироваться, упорядоченная зависимая служба не стартует; однако автоматическое обнаружение последующего «зависания» внешней БД этими директивами не обеспечивается. Wants слабее: запросить другую службу, но не делать её неуспешный запуск достаточной причиной провала своего старта. Реальное поведение также зависит от типа службы и условий; не превращаем две строки в обещание полной health-оркестрации. На доске рисуем разные цвета для включения в граф и для порядка.
Аналогия: «есть только после приготовления» не означает, что кто-то уже поручил повару приготовить.
Практическое следствие: Нет. Ordering ограничивает порядок присутствующих заданий; активация задаётся отдельно.
Загрузка — граф, а не один длинный shell-скрипт
Независимые работы можно выполнять одновременно.
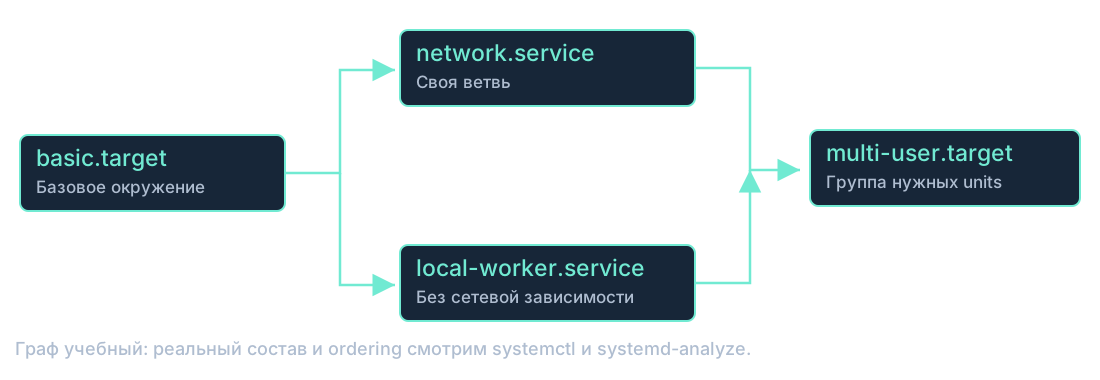
При запросе target менеджер собирает транзакцию заданий из зависимостей. Ordering задаёт допустимый порядок; независимые ветви могут выполняться параллельно. Поэтому полезно различать общую длительность запуска и критическую цепочку. systemd-analyze critical-chain показывает цепь задержек согласно данным менеджера, blame ранжирует длительности активации units, но не является автоматическим доказательством причины общей медленной загрузки. Служба может стартовать долго параллельно и не задерживать интересующий target. Граф на слайде намеренно учебный: состав реальных targets зависит от дистрибутива, режима и настроек. Уточняйте systemctl list-dependencies и эффективные unit-файлы вместо заучивания универсальной последовательности. Для WSL результаты не равны времени холодной загрузки физического ноутбука.
Аналогия: ремонт кухни и уборка кабинета идут одновременно; общий срок зависит от необходимых зависимостей, а не суммы всех работ.
Практическое следствие: Нет. Нужны зависимости и критический путь, а работа могла выполняться параллельно.
active ещё не значит «готов отвечать»
Событие старта зависит от Type; готовность проверяется по контракту.
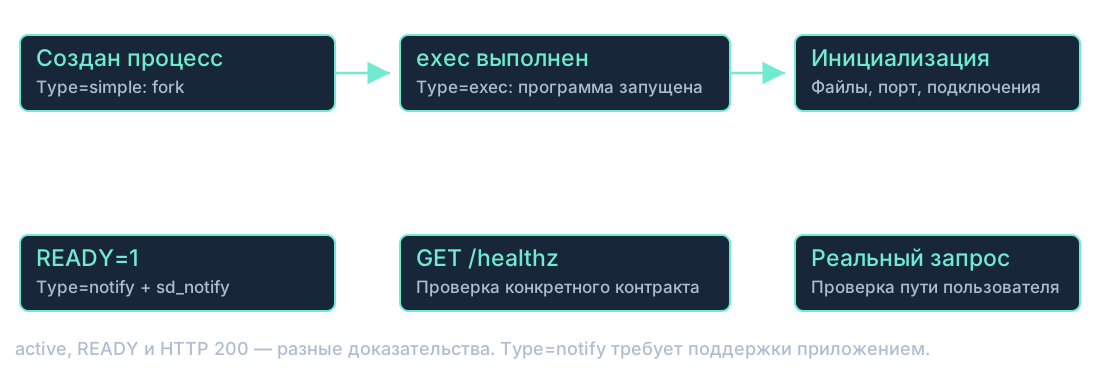
Для Type=simple менеджер считает службу запущенной после создания основного процесса, до подтверждения успешного exec. Type=exec ждёт успешного выполнения exec, поэтому лучше обнаруживает ошибки запуска исполняемого файла. Ни один из этих типов не доказывает, что приложение закончило инициализацию и открыло порт. Type=notify ждёт уведомления READY=1 от поддерживающего это протокол приложения; нельзя просто поменять Type на notify у произвольного Python и ожидать успеха. Даже готовность менеджера не гарантирует правильный ответ на пользовательский запрос. В лабораторной используем статус, журнал, затем curl /healthz и реальный запрос /predict. Аналогично network-online.target зависит от настроенного wait-online механизма и не обещает бесконечную доступность внешнего API или Интернет-соединения.
Аналогия: работник пришёл, инструмент запущен и заказ успешно выполнен — три разные проверки.
Практическое следствие: Нет. Это свидетельство состояния менеджера; нужен запрос, который проверяет выбранный контракт.
start и enable не взаимозаменяемы
Сейчас работать и участвовать в будущей активации — разные свойства.
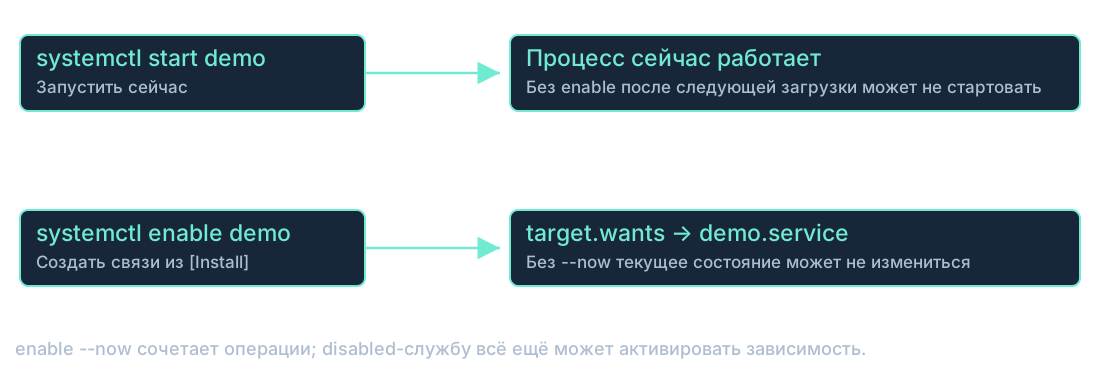
Start запросит запуск unit сейчас. Enable использует [Install], чтобы создать необходимые связи, например target.wants/demo.service. Без --now enable не обязан запустить процесс немедленно, а start без enable не обеспечивает автоматический запуск после следующей обычной загрузки. Enable --now совмещает действия. Disabled не означает «невозможно запустить»: unit может быть запущен явно, через зависимость, socket или timer. Disable удаляет связи установки, но не обязан остановить уже работающую службу; --now дополнительно запрашивает остановку. После редактирования файла нужен daemon-reload, чтобы менеджер перечитал описание; это не рестарт приложения. В курсе избегаем изменения системного default target: достаточно пользовательского сервиса и проверки связей.
Аналогия: записать работника в завтрашнее расписание и вызвать его сейчас — отдельные операции.
Практическое следствие: Нет. Без --now установка связей не равна немедленному start; смотрим статус и журнал.
Restart не лечит причину сбоя
Пауза и лимит защищают от бесконечного быстрого цикла.
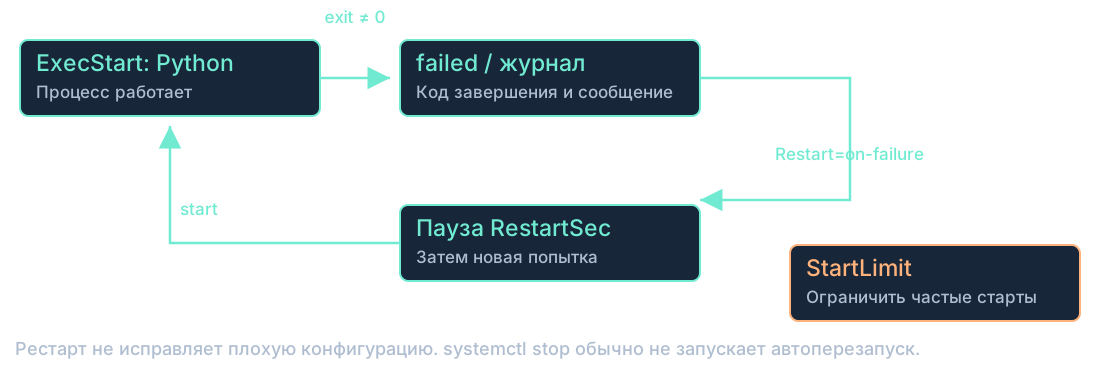
Restart=on-failure позволяет повторный запуск после заданных категорий неуспешного завершения. RestartSec задаёт задержку, а start rate limiting ограничивает слишком частые попытки. Если ExecStart указывает на несуществующий файл или конфигурация неверна, повторение не делает файл правильным. Сначала читаем journal и код завершения. Штатный systemctl stop обычно не активирует автоматический Restart даже при Restart=always. При остановке systemd обычно посылает TERM, ждёт TimeoutStopSec и при необходимости применяет финальный KILL согласно настройкам; KillMode определяет охват процессов, обычно control-group. Приложение обязано реализовать собственное корректное завершение. Не демонстрируем общий restart сервера: останавливаем только свой учебный unit. Восстановление должно подтверждаться запросом, а не только новым PID.
Аналогия: диспетчер снова вызывает мастера, но одинаково неверный адрес продолжит приводить к отказу.
Практическое следствие: Нет. Это может быть цикл падений; журнал и пользовательский путь покажут причину.
Состояние → журнал → конкретная проверка
Собираем доказательства одной причины, затем проверяем исправление.
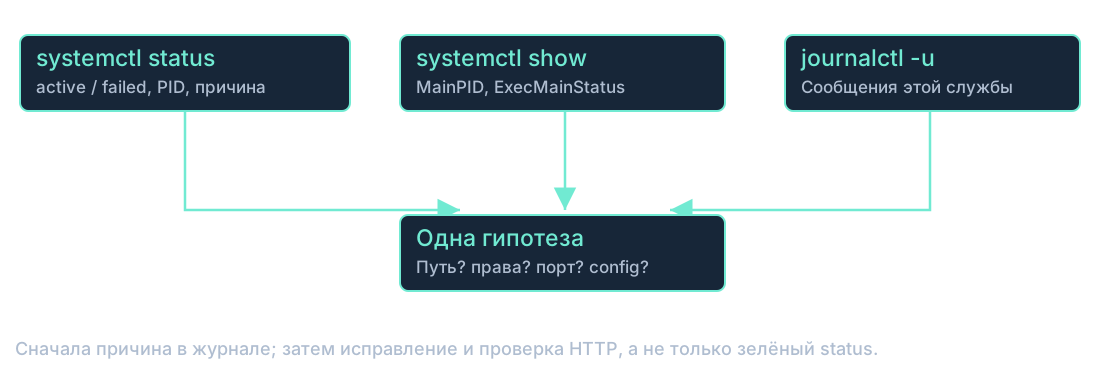
Systemctl status даёт удобный снимок, но его короткий журнал может обрезать важную строку. Systemctl show позволяет получить MainPID, ExecMainStatus, Result и другие свойства. Journalctl -u отбирает сообщения системной службы, для user-unit используем journalctl --user -u. -b ограничивает текущую загрузку, -n количество записей, --no-pager удобно для короткой демонстрации. Причины старта часто прозаичны: неверный абсолютный путь, отсутствие WorkingDirectory, права на файл, занятый порт или окружение, которое раньше задавал интерактивный shell. ExecStart не является обычной строкой Bash: pipe, > и && без shell не работают как ожидает новичок. Не добавляем sh -c без необходимости; конфигурируем рабочую папку и окружение явно. Перед публикацией журнала удаляем секреты и личные пути.
Аналогия: письменная инструкция должна включать то, что в привычной мастерской делалось молча.
Практическое следствие: Окружение, cwd, пользователь и способы разбора команды отличаются; нужно сравнить именно эти факты.
systemctl и systemctl --user управляют разными менеджерами
Системный сервер, сеанс пользователя и контейнер — разные области.
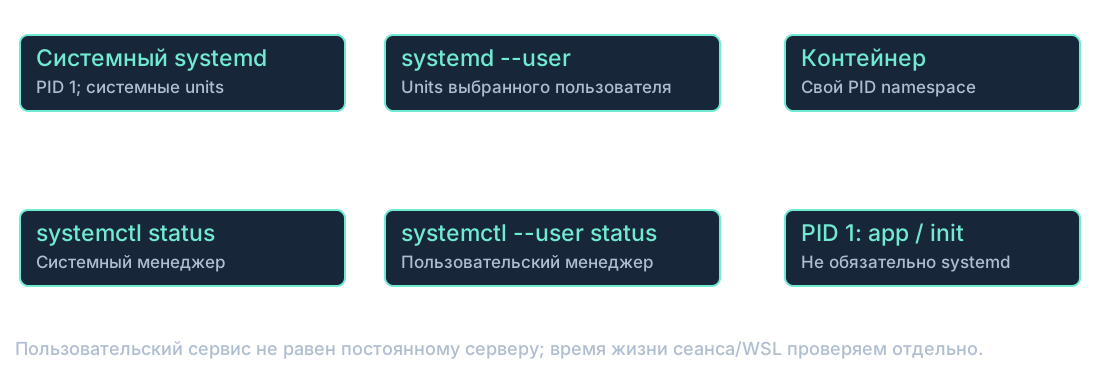
Пользовательский manager запускает units пользователя из ~/.config/systemd/user; systemctl --user обращается к нему. Системный manager использует системные пути и другой набор units. Перепутанный флаг часто даёт unit not found, хотя файл существует. Время жизни user-manager связано с сеансом и настройками lingering; включение lingering меняет поведение и не требуется бездумно для каждой лабораторной. В WSL дополнительно учитываем время жизни самой среды. В контейнере PID 1 может быть приложение или маленький init; Docker restart policy относится к контейнеру, а не автоматически к systemd-unit внутри него. В macOS аналог задач постоянных служб — launchd с plist и launchctl, в Windows — SCM с Windows service; обычный shell-скрипт ещё не превращается в нативную Windows service.
Аналогия: диспетчер здания и координатор вашей команды ведут разные расписания, даже когда называют задания одинаково.
Практическое следствие: Проверяется системный manager; для пользовательской службы нужен --user.
Логи нужно искать по источнику
kernel journal, journal службы и файл приложения — разные потоки.
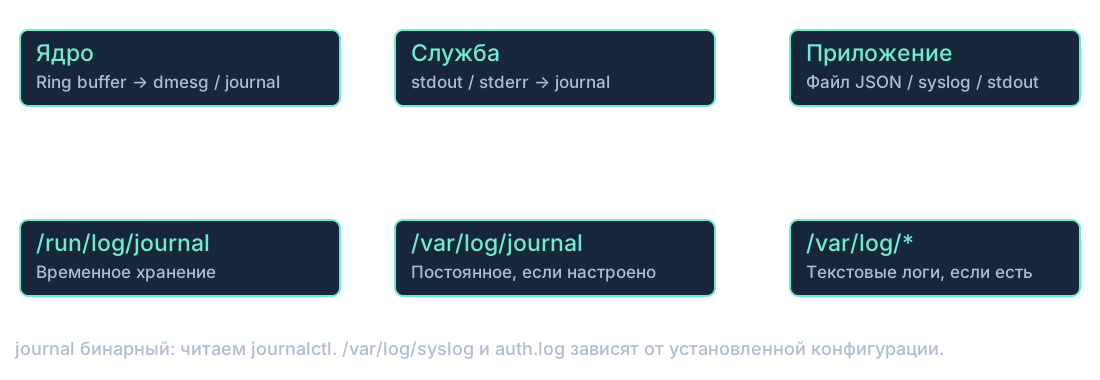
Dmesg читает сообщения ring buffer ядра, доступ может ограничиваться политикой системы. Journald собирает записи с metadata, включая службу, PID, boot и время; journalctl умеет фильтрацию по этим признакам. Journal хранится в бинарном формате: его не читают cat как текст. /run/log/journal предназначен для временного хранения; /var/log/journal используется для постоянного согласно Storage и конфигурации. Текстовые /var/log/syslog и /var/log/auth.log существуют при соответствующей syslog-конфигурации, а не обязаны присутствовать в каждой Ubuntu/container. Приложение может писать свой файл или stdout; Docker logs показывает stdout/stderr контейнера, но не любой файл внутри него. Ротация и retention ограничивают размер и срок хранения. Для расследования сохраняют контекст времени, версии и request_id, не раскрывая секреты. Смена timezone или неверные часы усложняет сопоставление.
Практическое следствие: journalctl -k -b; journalctl -u имя.service -b; journalctl --user -u studypulse.service; ls /var/log — каждый инструмент смотрит свою область.
Опыт: связать рисунок с наблюдением
ps -p 1 -o pid,comm,args
systemctl --user cat studypulse.service
systemctl --user show studypulse.service -p MainPID -p Result -p ExecMainStatus
journalctl --user -u studypulse.service -n 20 --no-pager
curl --fail http://127.0.0.1:8000/healthz
# Optional dependency exercise
python3 lab/experiments/systemd_graph.py

journalctl -k -b -n 20 --no-pager
journalctl --user -u studypulse.service -n 20 --no-pager
ls -lah /var/log
systemctl --user show studypulse.service -p StandardOutput -p StandardError
Используйте исходный unit StudyPulse из lab/README.md. Покажите [Unit], [Service], [Install] и объясните каждую уже использованную директиву. Сравните start с enable; после ошибки прочитайте journal, исправьте путь и подтвердите HTTP. Дополнительный опыт systemd_graph.py создаёт только уникальные временные user-units, сравнивает After с Requires+After и удаляет их после завершения. Запускается только в Ubuntu с доступным systemd --user. На Mac обсуждаем схему и изучаем launchctl list; чужие plist не меняем.
Найдите сообщение запуска StudyPulse по unit и времени, затем request_id в JSON-логе. Укажите, что переживёт reboot в текущей конфигурации, а не в предполагаемом универсальном Linux.
Источники подробного разбора
Пара 10: Базовый ремонт Linux по подтверждённой причине
Подробный разбор: Базовый ремонт Linux по подтверждённой причине
Диагностика: от симптома к причине
Исправление должно изменить причину и быть проверено тем же пользовательским действием.
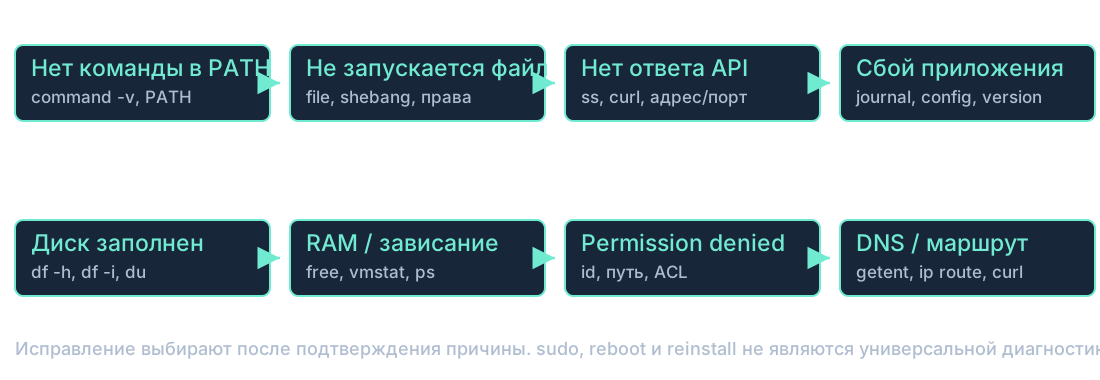
Command not found: проверить имя, command -v и PATH. Permission denied: проверить пользователя, rwx/ACL каждого родительского каталога, executable bit и noexec; sudo не исправляет неверный путь. Existing file + no such file: проверить interpreter shebang и PT_INTERP ELF, включая CRLF. Address already in use: найти собственный слушающий PID через ss/lsof, затем выбрать свободный порт или штатно остановить нужный процесс. Connection refused часто означает отсутствие слушателя в выбранной точке, timeout имеет больше возможных причин; HTTP 500 уже относится к ответу приложения. No space left: проверить df -h, df -i и du, затем deleted-open files; свободные байты не решают исчерпанные inode. Killed: проверить OOM и ограничения, не объявлять любую остановку нехваткой RAM. Missing .so: выяснить dependencies и совместимый пакет. После исправления повторить исходную команду и HTTP-запрос, сохранить минимальный runbook. Не использовать reboot/reinstall как способ стереть диагностические данные.
Практическое следствие: Подтвердите причину, исправьте её и повторите исходный запрос.
Опыт: связать рисунок с наблюдением
command -v python3
file app.py
pwd
id
ls -ld . data
df -h .
df -i .
ss -lntp
curl --max-time 3 -i http://127.0.0.1:8000/healthz
Для каждого отказа запишите симптом, проверку, причину, минимальное исправление и проверочный запрос. Используйте только собственные процессы и файлы.
Источники подробного разбора
Пара 11: Git: от истории Linux к графу версий
Подробный разбор: Git: от истории Linux к графу версий
Git возник из требований разработки Linux
Разрыв с BitKeeper ускорил создание свободного распределённого VCS.
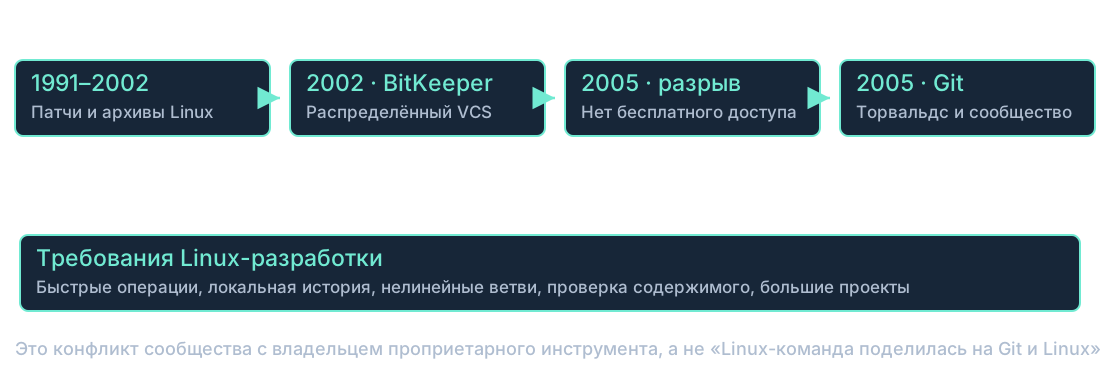
Linux долго принимал изменения в виде патчей и архивов. С 2002 года проект использовал проприетарный распределённый BitKeeper. В 2005-м отношения между сообществом Linux и владельцем инструмента нарушились, бесплатный режим использования прекратился. 6 апреля 2005 года в письме Kernel SCM saga Торвальдс сообщил о поиске замены после неудачных попыток разрешить конфликт вокруг использования BitKeeper. Он отдельно просил не сводить ситуацию к обвинению BitMover. Это создало практическую задачу быстро заменить важную часть процесса разработки. Торвальдс начал Git; дальнейшее развитие стало коллективным, а поддержка позже перешла к Джунио Хамано. Не сводим историю к «команда что-то не поделила»: конфликт касался условий и зависимости от внешнего проприетарного инструмента. Новый VCS должен был быстро работать с большой историей, поддерживать распределённую нелинейную разработку и локальные операции. Поэтому Git хранит историю локально и имеет дешёвые указатели ветвей. GitHub и GitLab — платформы вокруг Git, а не сам VCS.
Практическое следствие: Git решает задачу учёта и обмена изменениями, а не резервного копирования секретов или доставки сервиса сам по себе.
Commit — узел графа снимков
Branch — имя указателя; файлы и trees хранятся как объекты.
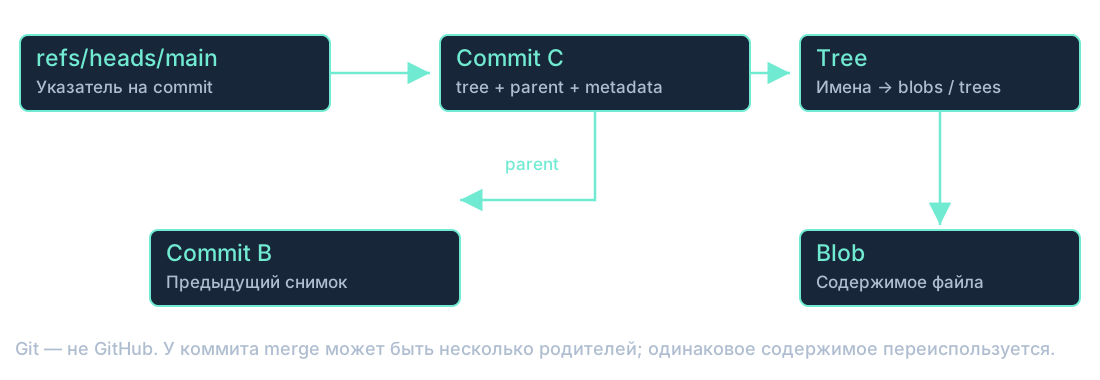
Blob хранит содержимое файла, tree связывает имена и режимы с blobs и вложенными trees, commit связывает корневой tree, родителей и metadata. Ветка — ref на commit, HEAD указывает на текущую ветку или прямо на commit в detached состоянии. Индекс/staging area описывает будущий снимок отдельно от текущего рабочего дерева. Поэтому git add выбирает состояние для commit, а последующая правка файла не меняет уже staged-версию автоматически. История — DAG: обычный commit имеет одного родителя, merge может иметь несколько. Git может эффективно хранить переиспользуемое содержимое, но пользовательская модель — снимки, а не копии папок branch-name. Hash идентифицирует объект согласно формату репозитория; это не универсальная подпись личности автора. Для практики создаём локальный репозиторий и смотрим cat-file, не начинаем с внешнего сервиса.
Практическое следствие: git cat-file -p HEAD показывает commit; git ls-tree HEAD — snapshot tree; git diff --staged — содержимое следующего снимка.
Опыт: связать рисунок с наблюдением
git log --oneline --graph --all
git cat-file -p HEAD
git ls-tree HEAD
git diff
git diff --staged
Сравните working tree, index и HEAD на одном маленьком файле. Не коммитьте .env, бинарный dataset и ключи доступа.